小米 AI 團隊在 9 月 22 日正式開源 MiMo-V2.6 系列模型,一口氣推出 Pro、Flash 與蒸餾版 Distill-Qwen-9B 三款規格,並宣稱旗艦版 MiMo-V2.6-Pro 是目前 Artificial Analysis 智慧指數(Intelligence Index)上排名最高的開放權重模型。更引人注目的是,小米這次只花了不到 6 天、總計 30 輪強化學習迭代,就把模型訓練到這個水準,讓不少開發者直呼「這個效率太誇張」。
三款模型一次到位:從旗艦到輕量都有
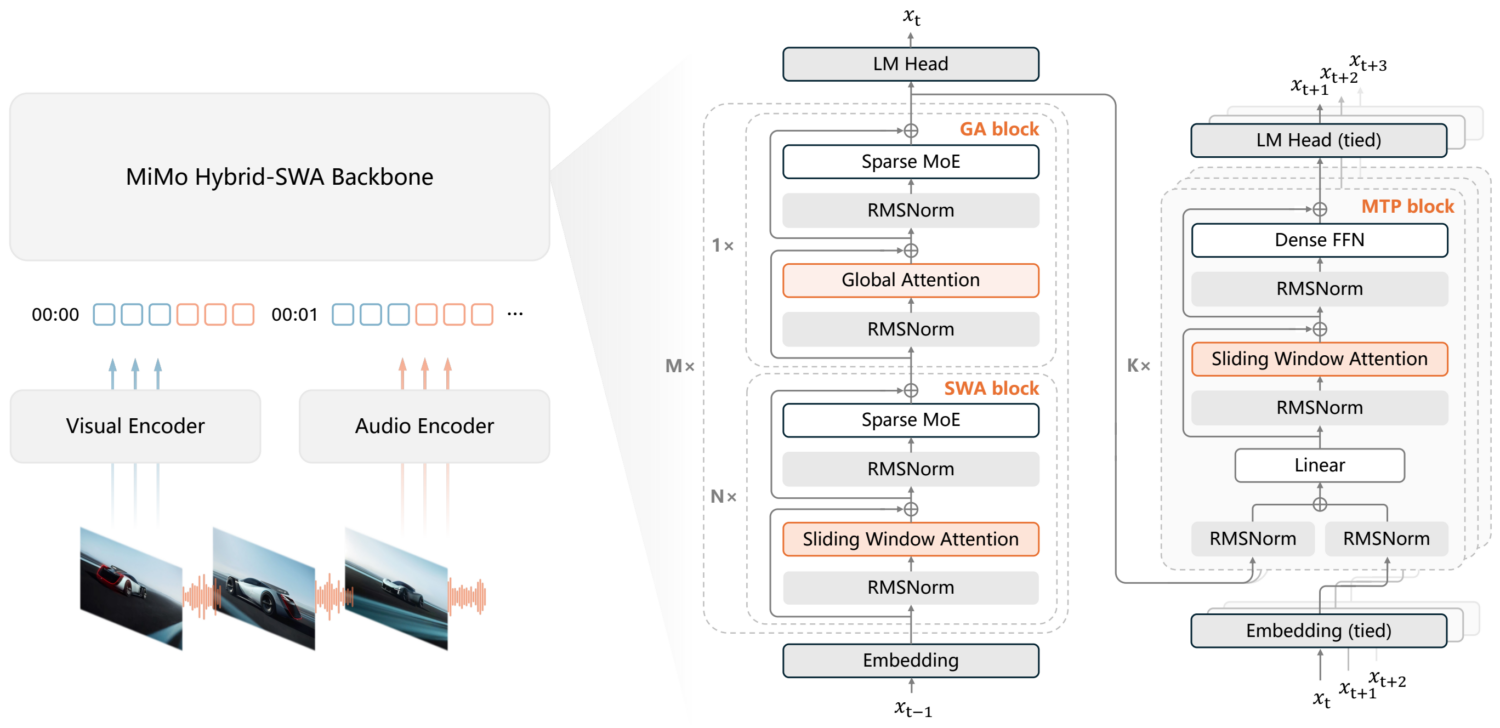
MiMo-V2.6 系列這次總共釋出三個版本。旗艦款 MiMo-V2.6-Pro 採用稀疏混合專家(Sparse MoE)架構,總參數量高達 1.02 兆,實際啟用(active)參數為 420 億,支援長達 100 萬 token 的上下文視窗,並且是同時處理文字、圖像、影片與音訊的全模態(omnimodal)模型。輕量版 MiMo-V2.6-Flash 則主打速度與成本,另外還有一款以 Qwen3.5 為基礎蒸餾出來的 MiMo-V2.6-Distill-Qwen-9B,方便資源有限的開發者在自有硬體上部署。三款模型全數以 MIT 授權開源,權重與技術報告皆已上架 Hugging Face 與 GitHub。
根據小米公開的模型卡資訊,MiMo-V2.6-Pro 的骨幹架構被稱為「MiMo Hybrid-SWA Backbone」,總共 70 層,其中 60 層採用滑動視窗注意力(Sliding Window Attention)、10 層為全域注意力(Global Attention),隱藏層維度 6,144,並配置 384 個路由式專家、每次啟用 8 個。多模態處理則由一顆 6.81 億參數的 MiMo ViT 視覺編碼器,搭配 3.08 億參數的音訊 Tokenizer 與 1.27 億參數的音訊區塊編碼器組成,另外還內建 5 層多重預測(MTP)解碼器,用來加速平行推論。
「You Only RL Once」:6 天、75 萬條軌跡練出來的強化學習成果
小米這次最想強調的重點,其實不是模型有多大,而是「練得有多快、多便宜」。團隊將這套訓練方法論稱為「You Only RL Once」,核心概念是讓同一輪強化學習同時涵蓋程式撰寫、通用 Agent 任務、視覺理解與資安攻防等多個領域,而不是像過去那樣針對每個能力分別訓練。搭配團隊自行設計的「Groupwise Agentic Grading」評分機制,以及「Multi-Prefix Multi-Teacher On-Policy Distillation」蒸餾技巧,小米表示整套 RL 流程僅花了 30 個訓練步驟、不到 6 天時間、累積約 75 萬條軌跡(trajectories)就完成收斂。
訓練成本方面,根據小米官方部落格公布並經 TechNode、VentureBeat 等外媒引述的數字,MiMo-V2.6-Pro 的訓練成本約為 262 萬美元,輕量版 Flash 則只花了約 85 萬美元;不過部分外媒報導的成本數字略有出入,落在 300 萬至 347 萬美元之間,差異可能來自是否把 RL 環境建置等額外算力成本一併計入。無論用哪個數字比較,對照動輒上億美元起跳的前沿模型訓練成本,MiMo-V2.6 的性價比都相當驚人。
Benchmark 表現:開放權重模型的新王
成效上,MiMo-V2.6-Pro 在 Artificial Analysis 智慧指數拿下 46 分,官方點名超越 Moonshot 的 Kimi K3(44 分)與智譜的 GLM-5.3(45 分),是目前所有開放權重模型中分數最高的一款;不過對照目前最頂尖的閉源模型(約 53 分),MiMo-V2.6-Pro 仍有一段差距,尚未真正追平封閉生態系的旗艦水準。在其他細分任務上,MiMo-V2.6-Pro 於 DeepSWE v1.1 拿下 71.9%、Terminal Bench 2.1 達 89.9%、Toolathlon-Verified 為 76.9%、資安攻防測試 CyberGym 高達 94.0%,視覺程式能力測試 MiMo VisualCoding 也有 72.3% 的表現,顯示這款模型在程式撰寫、終端機操作與資安情境上的實戰能力都相當扎實。
| Benchmark | MiMo-V2.6 Pro | MiMo-V2.6 Flash | MiMo-V2.5 Pro | Claude Opus 5 | GPT-5.6 Sol | Claude Fable 5 |
|---|---|---|---|---|---|---|
| Code Agent | ||||||
| DeepSWE v1.1 | 71.9 | 67.9 | 19.0 | 74.0 | 73.0 | 70.0 |
| ProgramBench | 26.5 | 26.0 | 12.5 | 37.0 | 25.0 | 33.0 |
| MiMo Code Bench | 63.2 | 61.2 | 40.4 | 68.6 | 59.3 | – |
| General Agent | ||||||
| AutomationBench v1.0.6 | 53.1 | 52.3 | 16.0 | 50.3 | 45.8 | 46.2 |
| Toolathlon-Verified | 76.9 | 73.6 | 49.1 | 80.6 | 74.9 | 77.9 |
| GDPval-AA 2.1 | 1673 | – | 1107 | 1708 | 1588 | 1595 |
| Agents’ Last Exam | 31.6 | 27.6 | 13.2 | 31.6 | 30.8 | 25.7 |
| Terminal Bench 4.0 | 34.9 | 28.8 | 1.5 | 49.0 | 39.9 | 42.4 |
| Terminal Bench 2.1 | 89.9 | 87.6 | 65.2 | 89.1 | 88.8 | 84.3 |
| OSWorld-Verified | 82.0 | 80.8 | – | 83.4 | 83.0 | 86.0 |
| JobBench | 62.0 | 61.2 | 25.0 | 65.7 | 45.4 | 57.4 |
| Cybersecurity | ||||||
| CyberGym | 94.0 | 95.1 | 40.0 | – | – | – |
| MiMo Cyber Bench | 80.2 | 77.2 | 0.0 | – | – | – |
| ExploitGym | 17.8 | 6.0 | 0.2 | 22.1 | 30.3 | 28.4 |
| ExploitBench | 47.9 | 25.3 | 16.6 | 70.0 | 78.5 | 78.0 |
| SEC Bench Pro | 66.3 | 47.5 | 17.7 | – | 79.1 | – |
| Visual Agent | ||||||
| MiMo VisualCoding | 72.3 | 71.5 | – | 70.0 | 73.4 | 69.1 |
電腦操作、3D 空間推理、桌面應用一次到位
除了跑分數字,MiMo-V2.6 系列也把重心放在「動手做事」的 Agent 能力上。官方模型卡列出的 AutomationBench、Toolathlon 與 OSWorld 等測試都與電腦操作(computer-use)直接相關,代表模型可以理解畫面、操作滑鼠鍵盤、跨應用程式完成連續任務;加上團隊同步推出「Xiaomi MiMo Desktop」桌面應用程式,讓一般使用者也能直接在電腦上呼叫模型執行操作型任務,而不必自己寫程式串接 API。此外,小米也特別強調 MiMo-V2.6 具備 3D 空間推理能力,能理解物件在三維空間中的相對位置與互動關係,這在機器人、自駕、工業檢測等需要空間理解的應用場景中會是重要差異化能力。目前這些電腦操作與桌面應用功能主要由小米官方公告與模型卡描述,實際大規模落地成效仍待更多第三方開發者實測驗證。
對開放權重生態的意義
MiMo-V2.6 的發布也再次凸顯中國陣營在開放權重模型競賽上的積極程度——短短時間內,Kimi K3、GLM-5.3 到這次的 MiMo-V2.6,都在 Artificial Analysis 智慧指數上互相較勁,逐步把開放權重模型的天花板推向封閉模型的水準。小米選擇在訓練過程中同步在 GitHub 上直播 RL 訓練儀表板,讓外界能即時觀察訓練曲線變化,這種「公開訓練」的做法也在 Hacker News 等技術社群引發不少討論,被視為近期少數敢把訓練過程攤在陽光下的頂尖規模模型專案之一。對開發者而言,MiMo-V2.6 系列以 MIT 授權釋出、搭配 SGLang 與 vLLM 的部署支援,加上相對低廉的訓練成本示範,等於再次證明了「小預算也能練出接近前沿水準模型」這件事在技術上是可行的,後續是否會有更多團隊跟進這套「多領域合一 RL」的訓練思路,值得持續關注。