問題 3 / 5
想要在自有設備上部署輕量版或蒸餾版模型,最容易遇到哪些硬體或軟體瓶頸?該如何克服?
AI 根據文章內容回答
開發者在本地部署這類多模態且支援長上下文的模型時,最常卡在顯存(VRAM)不足與推論吞吐量過低這兩個瓶頸:
- 長上下文與多模態導致顯存爆表:雖然 9B 蒸餾版模型體積較小,但如果開啟高解析度圖片輸入或極長的 Context Window(如超過 32K token),KV Cache 會快速吃光顯存。解決方式是採用 4-bit 或 8-bit 量化技術(如 AWQ、GPTQ),能顯著降低顯存佔用。
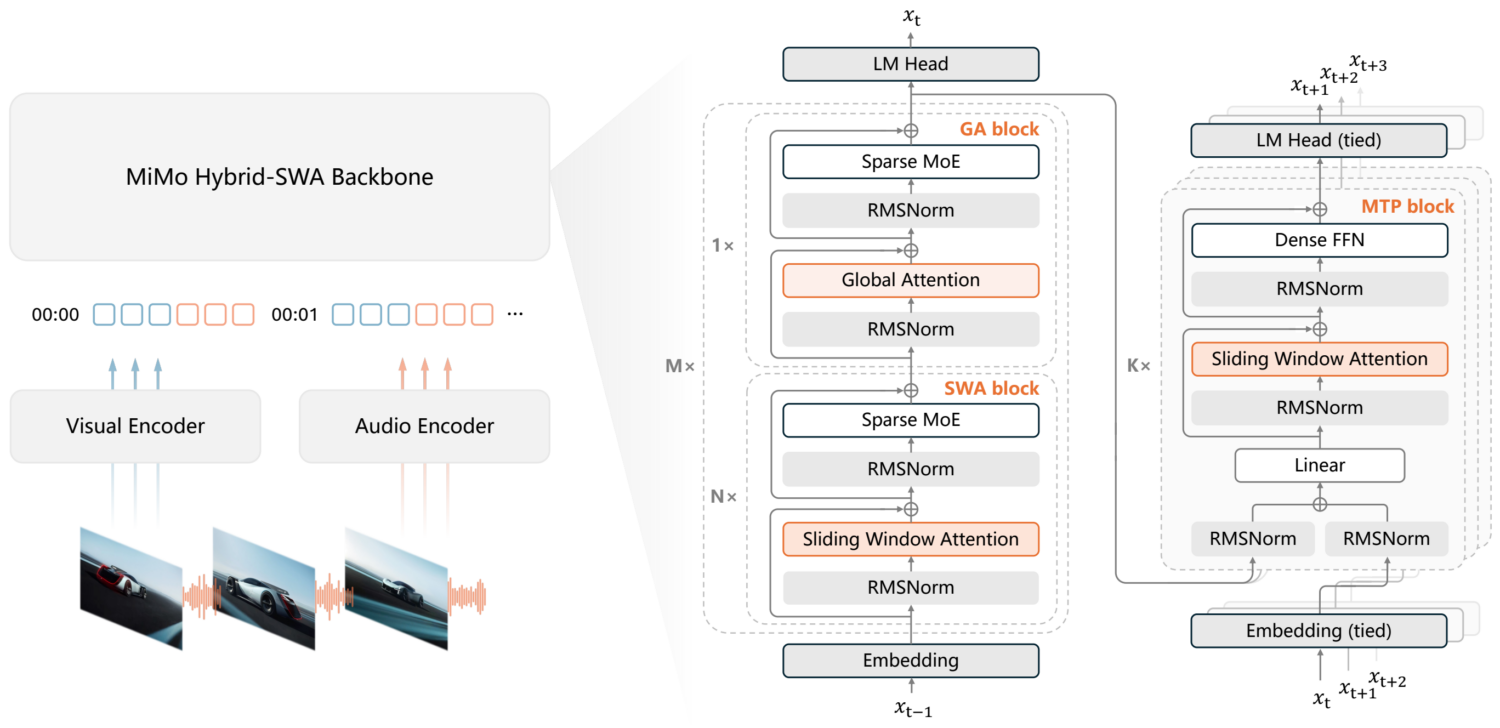
- 推論引擎選擇不當:直接使用原生 PyTorch 執行可能會遇到嚴重的推論延遲。強烈建議搭配官方推薦的 vLLM 或 SGLang 框架,這些推論引擎對混合專家(MoE)與滑動視窗注意力(SWA)架構有深度優化,機能提升數倍吞吐量。
- 多模態依賴套件相容性:部署時需特別注意視覺編碼器與音訊 Tokenizer 的 Python 套件版本,確保輸入格式與官方預處理流程完全一致,避免出現解析錯誤。