問題 1 / 5
如果我想要立刻把這套模型拿來做日常專案或程式開發,該如何在 Pro、Flash 和 9B 蒸餾版之間選擇?
AI 根據文章內容回答
選擇哪一款模型,主要取決於你的硬體設備限制與實際應用情境:
- MiMo-V2.6-Distill-Qwen-9B(個人與在地化首選):非常適合個人開發者或預算有限的團隊。只要一張消費級顯示卡(如 RTX 4090)就能在本地端順暢執行,適合用於個人程式碼輔助、基礎文本摘要或隱私要求高的日常任務。
- MiMo-V2.6-Flash(高性價比極速版):如果你要打造高併發的 API 服務,或是需要即時回應的客服與 Agent 任務,這款模型在推理速度與算力成本上取得極佳平衡,建議配合 vLLM 或 SGLang 推論框架部署。
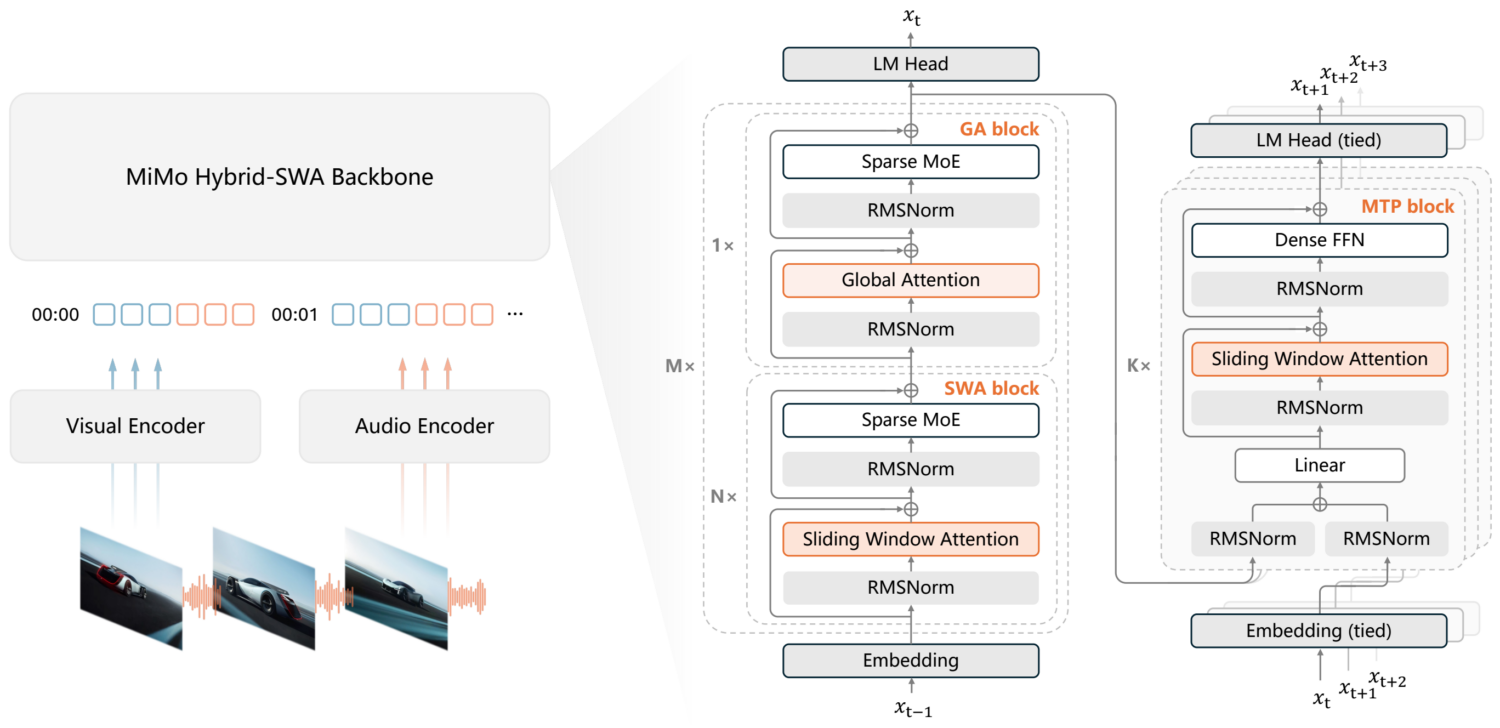
- MiMo-V2.6-Pro(全能旗艦版):適合處理複雜的多模態任務(如同時分析圖表與音訊)、100 萬 token 超長文本分析,或是極高精度的資安檢測與大型專案開發。由於啟用參數達 420 億,建議直接採用多卡伺服器集群或雲端 API 來運行。