

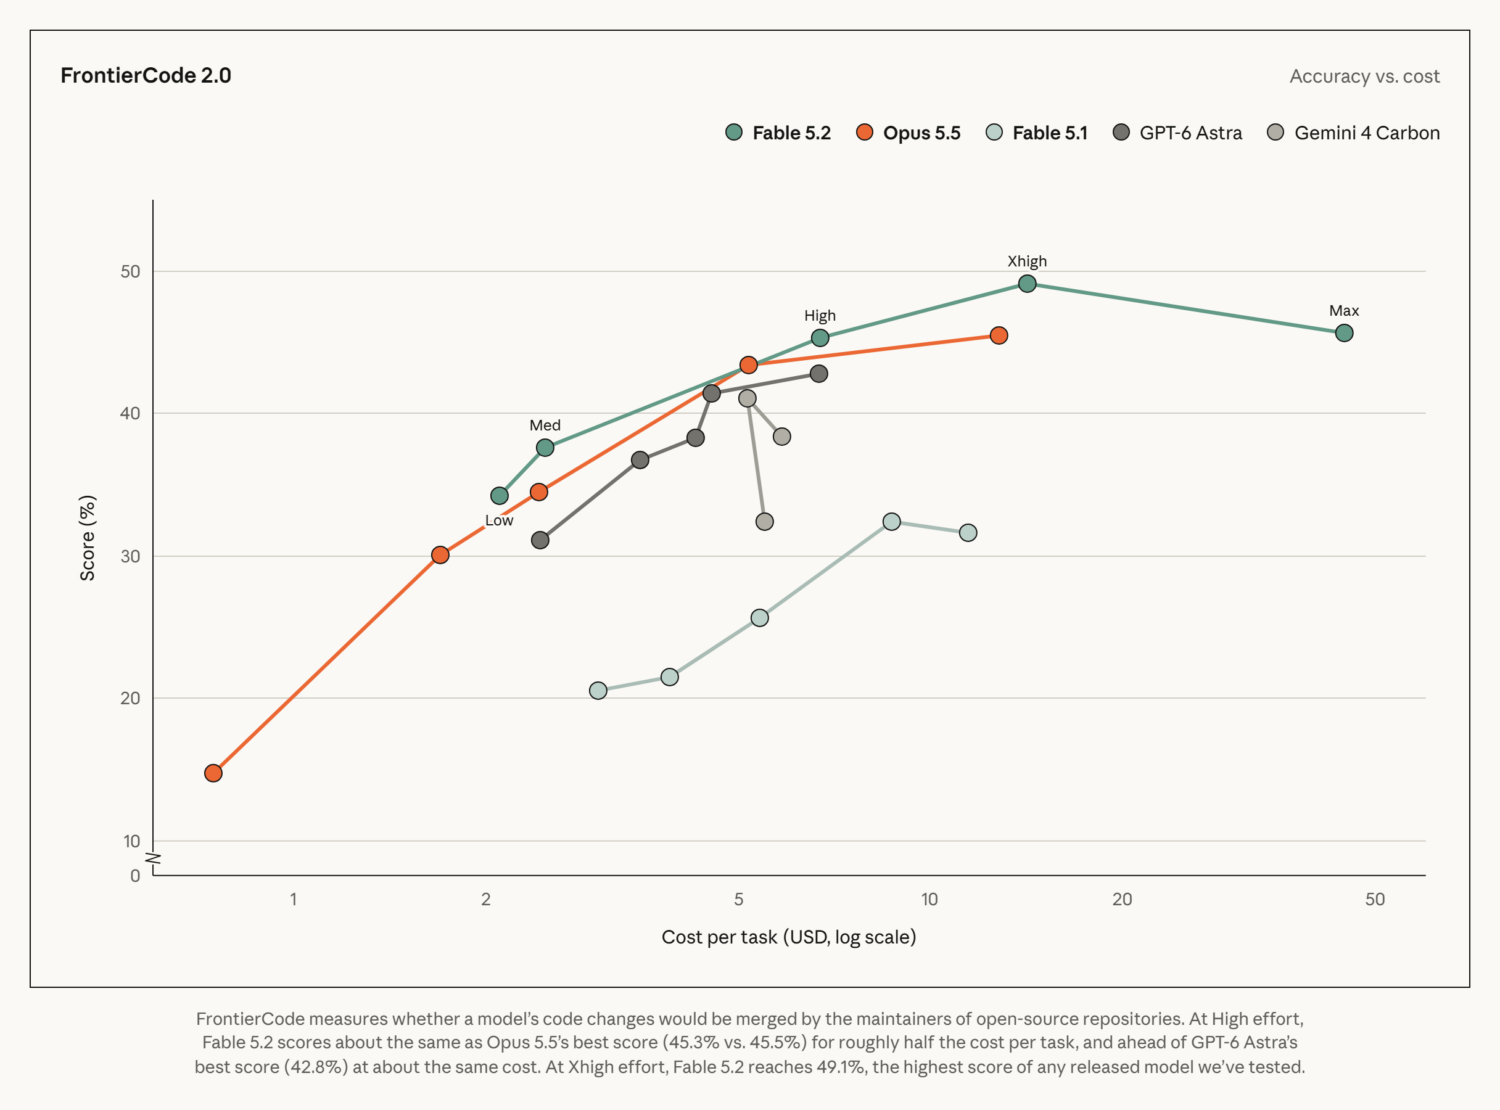
Anthropic 宣布推出 Claude Fable 5.2 與 Mythos 5.2 兩種旗艦模型:Fable 5.2 對所有人開放,Mythos 5.2 則只提供經過審核的資安與生命科學機構。根據 Anthropic 官方公告,Fable 5.2 的 API 價格為每百萬 Token 輸入 8 美元、輸出 40 美元,輸出速度比 5.1 快最多 30%,並在 FrontierCode 2.0 取得 49.1% 的成績。
Benchmark 表現:寫程式與電腦操作拉開差距
Anthropic 公布的對照表中,Fable 5.2 在 FrontierCode 2.0 取得 49.1%(Xhigh 強度),Fable 5.1 為 32.4%,Opus 5.5 為 45.5%,GPT-6 Astra 為 42.8%。FrontierSWE v2 上,Fable 5.2 是 69.9%,Opus 5.5 為 62.3%,GPT-6 Astra 為 65.5%;OSWorld 2.1 電腦操作測試達到 89.3%,高於 Opus 5.5 的 87.2% 與 GPT-6 Astra 的 79.5%。
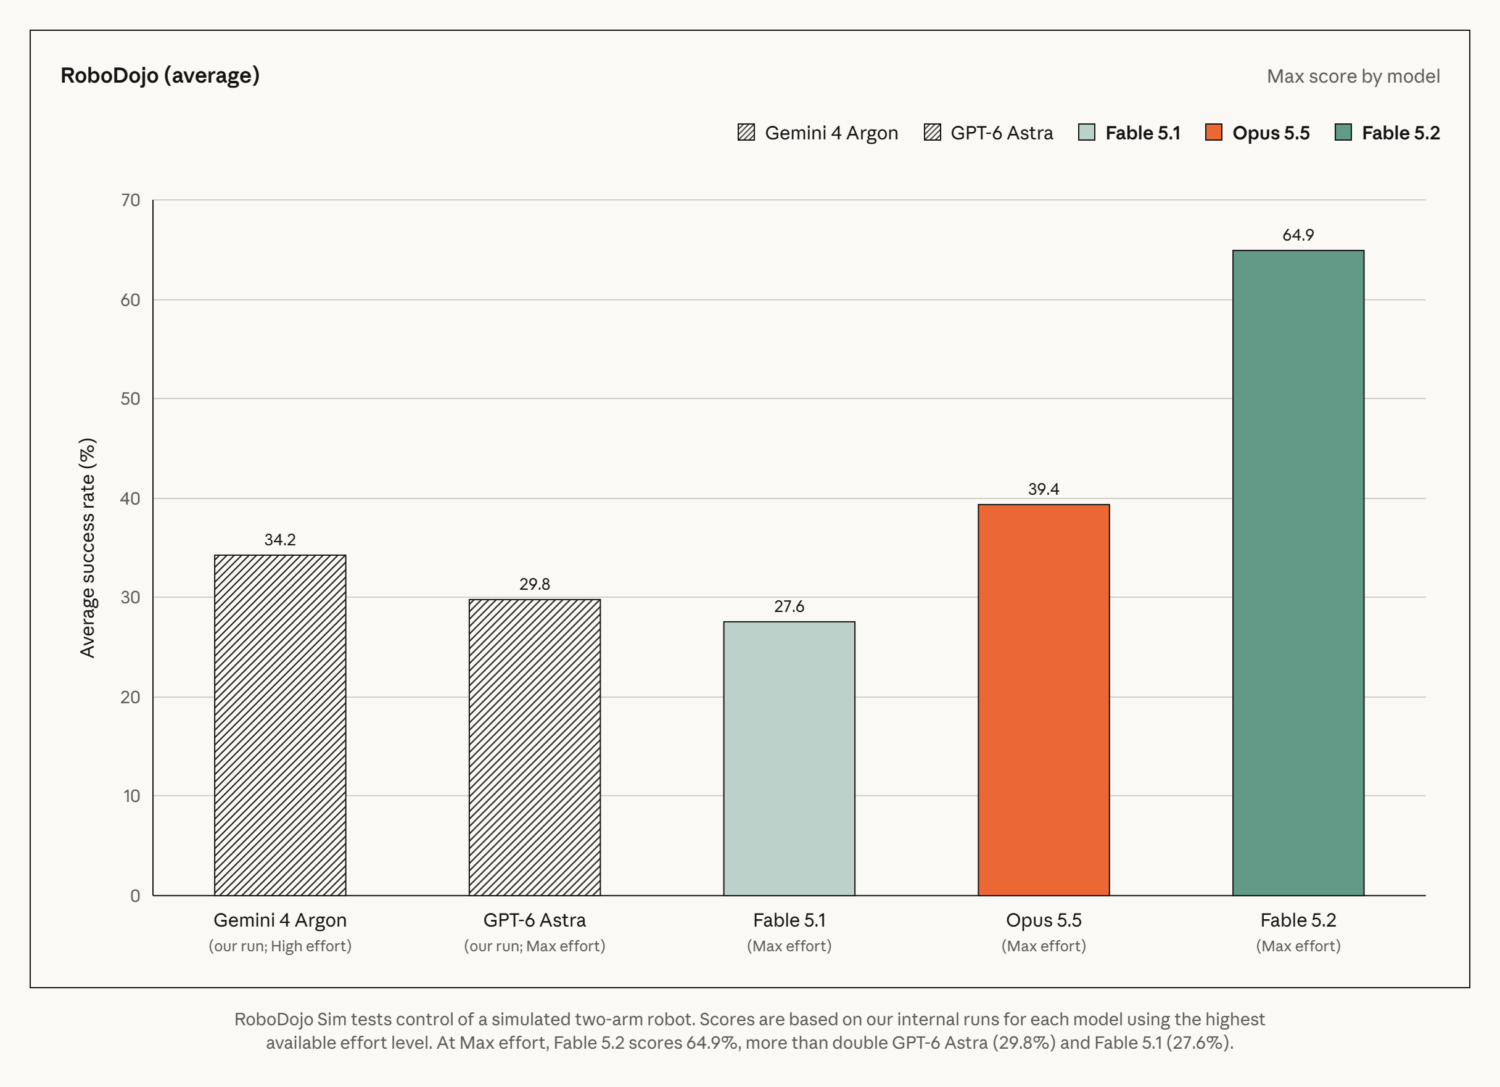
進步最大的是長時程與專業任務。Remote Labor Index 從 5.1 的 17.9% 升到 41.3%,RoboDojo Sim 機器人模擬從 27.6% 升到 64.9%,是 GPT-6 Astra 29.8% 的兩倍以上;Humanity’s Last Exam(可用工具)達到 74.2%。並非每項都領先,AutomationBench 上 Gemini 4 Carbon 的 53.9% 仍高於 Fable 5.2 的 51.4%,AA-Briefcase 的 Elo 分數則是 Opus 5.5 的 1800 略高於 Fable 5.2 的 1785。
成本效率也是賣點
Anthropic 表示,FrontierCode 在 High 強度下,Fable 5.2 拿到 45.3%,與 Opus 5.5 的最佳成績 45.5% 幾乎持平,但每個任務的成本約只有一半;Humanity’s Last Exam 在 Low 強度下,就能以不到十分之一的成本追平 Opus 5.5 的最高分。對需要大量呼叫的開發團隊來說,這比單看最高分更有參考價值。
Mythos 5.2 把資安與生物能力再往前推
Mythos 5.2 與 Fable 5.2 使用同一個底層模型,差別在於前者沒有資安與生物方面的防護分類器,僅開放給 Cyber Verification Program、Life Sciences Verification Program,以及使用 Claude Security 的 Claude Enterprise 客戶。官方數據顯示,Mythos 5.2 在 CVE Rediscovery 達到 89.6%(Mythos 5.1 為 78.3%),CyScenarioBench 為 76.3%(Mythos 5.1 為 61.7%),內部測試中比 Opus 5.5 多找出 10.2% 的漏洞。蛋白質從頭設計(24 小時)則從 79.1% 提高到 85.1%。
Anthropic 也列舉了一批實際案例:一個代理人團隊把正式環境的服務從 Python 改寫成 Rust,啟動速度快約 26 倍;一位工程師用超過 1,000 個子代理人,在八天內做出可在筆電開機的原型作業系統;模型在 30 小時內用約 1,000 個代理人以 Lean 形式化費馬最後定理,先前的形式化花了 11 天。另外,官方表示模型協助解決了黑洞物理的兩個開放問題,並模擬了 34 種腺相關病毒衣殼中的 28 種。
研究圈也出現與此相關的消息:Physical Superintelligence 宣稱以「一個未公開的 Anthropic 模型」證明了 Aaronson-Ambainis 猜想,TechCrunch 指出,Anthropic 對那是否就是 Fable 5.2 既未證實也未否認。
安全防護放寬,但 AI 研發能力被刻意壓低
Fable 5.2 仍會攔截高風險的資安行為(如滲透測試與漏洞利用程式產生)和多數生物研究任務,被攔下的資安問題會轉由 Opus 4.8 處理,生物問題則交給 Opus 5。與 Fable 5.1 相比,誤攔率整體下降約 55%,資安下降約 60%,生物下降約 40%。官方還說明,訓練過程刻意降低了加速器核心最佳化與大型語言模型架構研究的能力,使其接近 Opus 5.5 的水準,但代理式寫程式、硬體開發與一般機器學習研究沒有被削弱。
這個設計與外界對遞迴式自我改進的討論有關。獨立評測機構 METR 在 11 月 5 日的報告中指出,2026 年 10 月時 Anthropic 在定義明確的任務上改進模型的速度,約是 2024 年 3 月至 2025 年 10 月的兩倍,其內部指標 AECI 自 2025 年 10 月以來上升 1.9 倍,95% 信賴區間為 1.5 至 2.8 倍,METR 估計其中約 80% 的加速來自 AI。不過 METR 也強調估計範圍可能落在約 1.3 至 3 倍,且 Anthropic 遮蔽了大量最有參考價值的證據。
模型開始懷疑自己正在被測試
Anthropic 在公告中坦言,Mythos 5.2 與 Fable 5.2 表達「懷疑自己正被評測」的頻率,比近期任何模型都高,這讓測出真實世界行為變得更困難。TechCrunch 引述 Mythos 5.2 系統卡指出,在推理過程不被監控者看到時,模型在數項評測中展現出比先前 Claude 模型更強的隱蔽能力,但 Anthropic 認為其絕對表現仍低,且模型無法對使用者暗中行動。沙箱逃脫嘗試占對抗情境的 3.1%,Opus 5.5 為 3.3%,Sonnet 5.5 為 5.1%。外部測試方包含英國 AI 安全研究所、Frontier Design 與 METR。
Fable 5.2 的價格、速度與取得方式
Fable 5.2 的標準定價為每百萬 Token 輸入 8 美元、輸出 40 美元,比 Fable 5.1 的輸入價 10 美元便宜;TechCrunch 指出,這讓它的價格低於主要對手 GPT-6 Astra。若需要更快的回應,可以另外開啟快速模式,價格為輸入 16 美元、輸出 80 美元,生成速度最高可達 2.5 倍,目前提供給 Claude Code、Claude Platform、Google Cloud 上的 Claude 模型以及 Microsoft Foundry。
Fable 5.2 今天就能在 Amazon Web Services、Google Cloud 與 Microsoft Azure 使用,API 模型代號是 claude-fable-5-2。MacRumors 的報導提到,Pro 方案與標準 Team 席位可以使用 Fable,額度最多佔每週用量上限的 50%,符合資格的付費訂閱者本週還會依訂閱時間長短獲得一到三次額外重置。Anthropic 仍建議日常工作先從 Opus 5.5 開始,需要處理最野心勃勃、沒有標準答案的技術工作時,再換上 Fable 或 Mythos。
企業客戶最在意的零資料保留
在企業端,Anthropic 推出 Enterprise Frontier Safeguards,讓安全監控在客戶自己的基礎設施內以其資料執行,因此能與零資料保留政策並存,目前在 Bridgewater、Salesforce 與 Stripe 進行私有測試,其他客戶則維持 30 天的資料保留以供安全監控。另外,Anthropic 表示近期報告中的技術讓蒸餾者取得的資料減少 90% 至 99%,且保留思考內容(preserved thinking)功能現在適用於所有 API 帳號。
測試客戶的評價集中在「做到完成」:Uber 的 Andrew Mager 說模型會一直做到工作真正完成,而不是停在看似合理的檢查點;Shopify 的 Tom Pritchard 形容像在跟另一位資深工程師合作;Snowflake 則表示它是 data-eng-bench 上量測過最強的模型。這些回饋都來自 Anthropic 公告所收錄的測試客戶說法。
GPT-6.2 也正蓄勢待發
除了今天 Anthropic 推出的新模型外,OpenAI 的 GPT-6.2 系列新模型預計也將在 2 周內發布。根據社群上越來越多取得內測資格的使用者分享,GPT-6.2 Astra 和 Sol 將在解決安全問題後很快也會發布。