
最近許多開發者在社群上反映,使用 Claude Code 時明顯感受到模型品質下降,不僅變得健忘,還會出現不斷重複的錯誤行為。Anthropic 官方團隊深入調查後,發布了完整的技術事後調查報告(Postmortem)。這次報告也指出體驗下滑並非模型本身能力衰退,而是由三次獨立的系統與產品更新疊加所致。目前官方已全面修復問題,並重置了所有訂閱者的使用額度 (賺到)。
我們為大家梳理這次事件的技術脈絡,看看 Anthropic 在這段時間做了什麼事情,導致 Claude Code 品質發生異常。
為什麼 Claude Code 感覺變笨了?
當開發者習慣了高智慧的輔助工具後,任何細微的品質下降都會被迅速察覺。Anthropic 在三月初就陸續收到使用者回饋,指出 Claude 的回應品質大不如前。經過官方確認,底層的 API 與推論層(Inference layer)完全沒有受到影響,真正的受災區集中在 Claude Code、Claude Agent SDK 以及 Claude Cowork 這些應用產品上。
由於造成影響的三個更新各自影響了不同比例的流量,且發布時間點錯開,導致整體現象看起來像是廣泛且不一致的模型能力退化,這也增加了官方初期除錯的難度。
三大問題點解析與前因後果
1. 預設推理難度的妥協
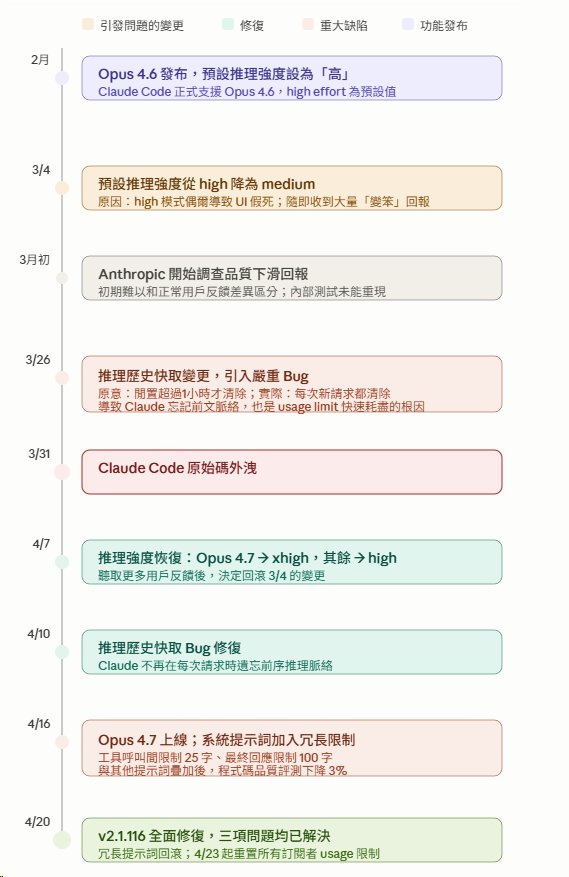
在二月份 Opus 4.6 推出時,官方將預設的推理難度(Reasoning effort)設定為「高」。雖然這帶來了絕佳的程式碼品質,但高難度意味著模型需要花費大量的時間進行思考。許多使用者反映這會導致介面看起來像當機一樣停滯,同時也消耗了不成比例的等待時間與 Token 額度。
為了取得效能與延遲之間的平衡,官方在三月四日將預設難度調降為「中」。在內部測試中,中等難度的延遲大幅降低,且智力僅有些微落差。然而,這項改動上線後,開發者們立刻感受到模型變笨了。最終,官方聆聽了社群的聲音,確認多數使用者更傾向預設享受最高智力,寧可自行在簡單任務中手動調降難度。這項改動已於四月七日回溯,目前 Opus 4.7 預設為極高(xhigh)難度,其餘模型則預設為高難度。
2. 快取優化機制引發的失憶症
當 Claude 在處理複雜任務時,過往的推理過程會被保留在對話歷史中,讓模型知道自己為什麼要採取特定的工具或修改。為了解省成本並提升速度,Anthropic 依賴提示詞快取(Prompt caching)技術。
官方在三月二十六日推出了一項立意良善的優化:如果使用者的開發工作階段(Session)閒置超過一小時,系統會清除舊的思考片段。因為這些過期的對話反正也無法命中快取,不如直接刪除以減少傳輸的 Token 數量。然而,實作上卻出現了致命的 Bug:系統並沒有只清除一次舊紀錄,而是在接下來的「每一個回合」都持續清除,導致 Claude 在執行連續動作或使用工具時,上一秒的推理過程下一秒就被刪除,模型因此失去了上下文記憶,表現出健忘、重複且荒謬的工具調用行為,同時也導致使用者的額度被異常消耗。這個嚴重的 Bug 最終在四月十日被徹底修復。
3. 限制字數的系統提示詞拖垮程式碼品質
隨著最新的 Opus 4.7 模型釋出,官方發現它有一個特性:非常囉嗦。雖然這讓它在解決難題時表現出色,但也產生了過多的輸出。為了優化體驗,工程團隊在系統提示詞中加入了一項限制,要求模型在調用工具間的文字保持在 25 字以內,最終回應限制在 100 字以內。
這個原本在內部測試中表現良好的改動,於四月十六日上線後,卻意外對程式碼撰寫品質產生了不成比例的負面影響。經過更廣泛的評估測試後,官方發現這行提示詞導致 Opus 4.6 與 4.7 的表現下降了 3%,因此迅速在四月二十日將其移除。
官方補償與未來防範措施
面對這次的事件,Anthropic 展現了負責任的態度,除了在四月二十三日全面重置所有訂閱者的使用額度外,也承諾將改善內部的開發與測試流程。
未來,Anthropic 將要求內部團隊擴大使用公開版本的 Claude Code 進行測試,避免內部實驗環境掩蓋了真實產品的 Bug。同時,他們也會升級內部使用的程式碼審查工具,並針對系統提示詞的更動實施更嚴格的逐行影響分析與漸進式發布策略。這次的事件不僅是一次系統除錯,也為所有 AI 開發者展示了在提示詞工程、快取管理與模型推理間取得平衡的困難與重要性。


重置額度哪裡賺到,時間快到的馬上就reset也用不了多久,剛reset的本來就沒用多久,合理的賠償應該照目前方案直接延長一個月吧
都還沒跟他算帳這一個月浪費的時間