xAI 於美國時間 9 月 21 日正式發表新一代旗艦模型 Grok 4.7,官方將其定位為「目前最強的程式設計與知識工作模型」,強調在困難任務上能work longer、更仔細檢查自己的輸出結果,並搭配至今最完整的安全防護機制。這款新模型即日起開放使用,且維持與前代 Grok 4.6 相同的價格與速度,讓不少開發者關注其性價比表現。
Grok 4.7 是什麼:鎖定程式設計與長時間知識工作
根據 xAI 官方公告,Grok 4.7 採用比 Grok 4.6 更大的新基礎模型,並經過更長時間的強化學習訓練,訓練任務組合特別加重「需要花費數小時才能完成」的高難度題型。官方表示,Grok 4.7 更擅長自我驗證輸出結果、管理更長的上下文,同時也針對 Grok 的工具使用環境進行原生訓練,讓模型在一般對話與知識型工作上的表現同步提升。
效能表現:CursorBench 4.0 性價比登頂,多項專業任務同步進步
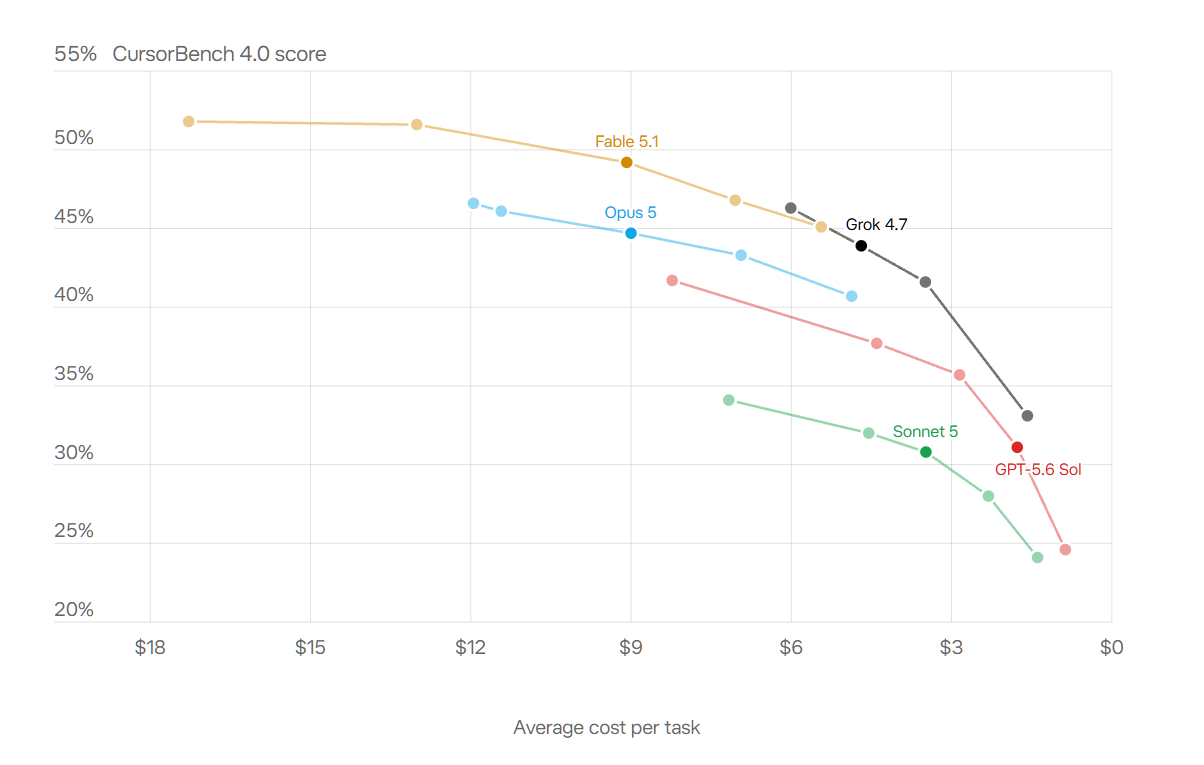
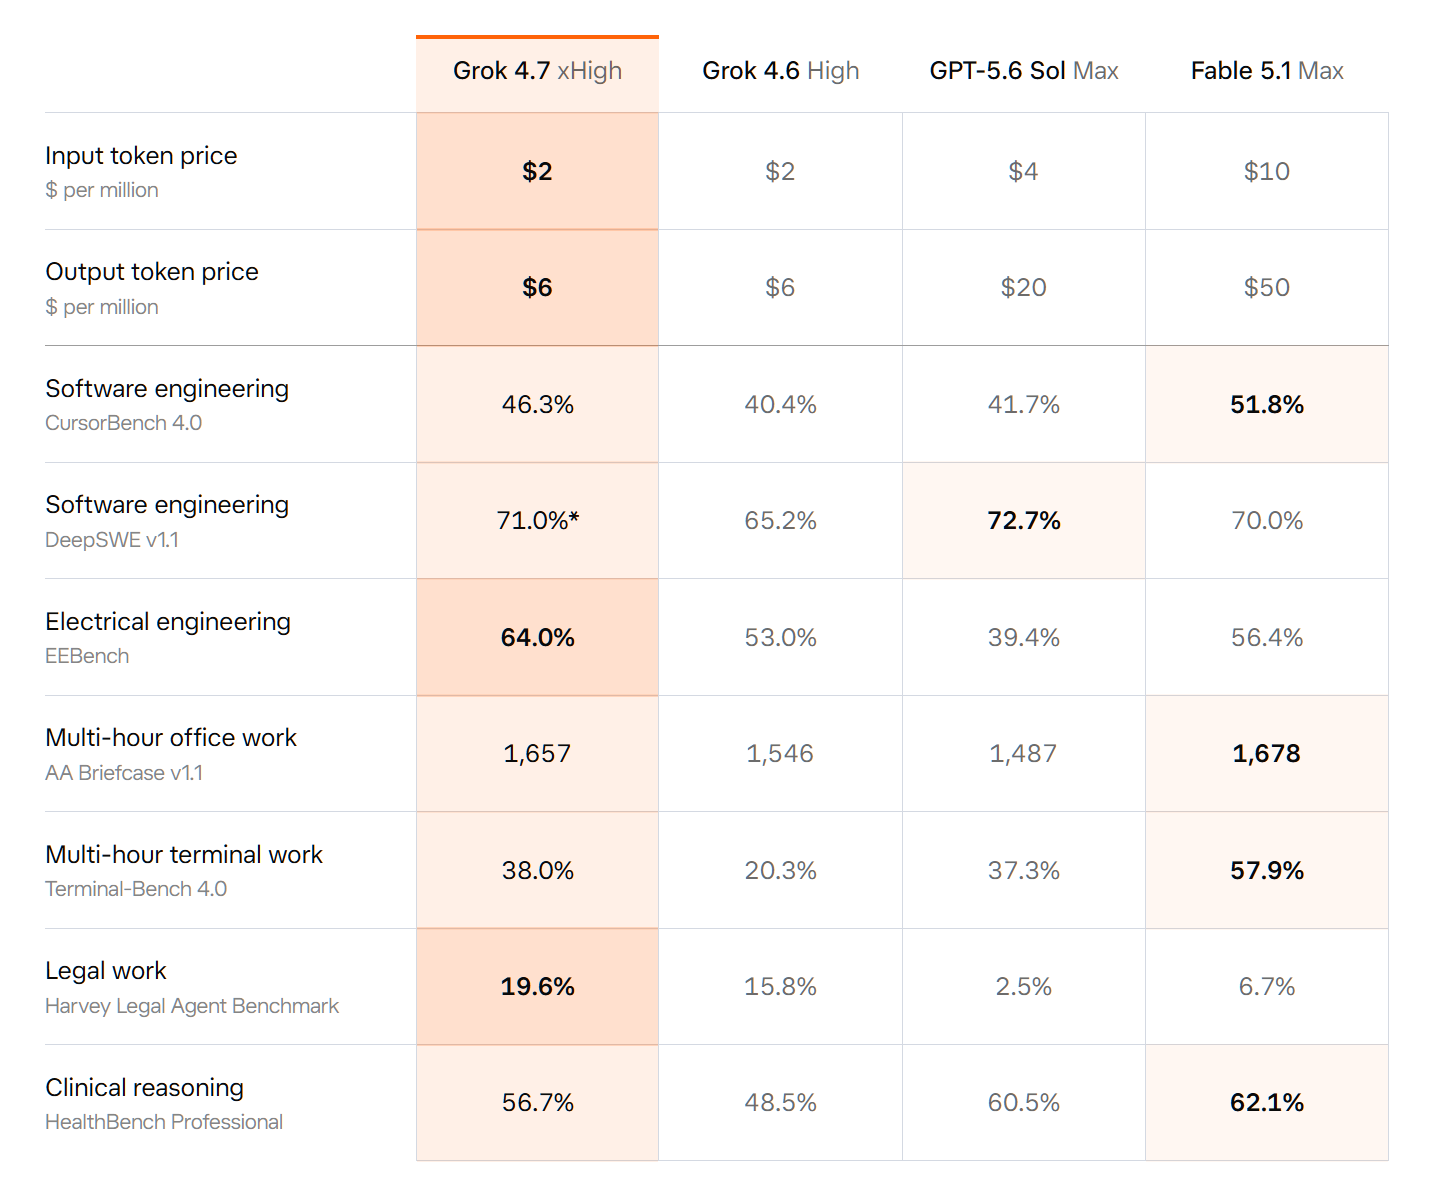
在強調長時間程式設計任務的 CursorBench 4.0 測試中,xAI 公布的散佈圖顯示 Grok 4.7 與 Fable 5.1、Opus 5、GPT-5.6 Sol、Sonnet 5 等對手相比,在「每項任務平均成本」與分數的權衡上站上前緣位置,也就是同樣花費下能拿到較高分數。官方同時公布了在 DeepSWE v1.1、EEBench(電機工程)、AA Briefcase v1.1、Terminal-Bench 4.0、Harvey Legal Agent Benchmark、HealthBench Professional 等多項針對軟體工程、電機工程、多小時辦公室工作與多小時終端機工作的基準測試成績,整體較 Grok 4.6 有所提升。
官方也特別提到,Grok 4.7 在文件與簡報製作能力上有進步,在 GDPval、AA Briefcase 這類模擬律師、護理師、財務分析師等專業人士實際工作內容的測試中,成績較 Grok 4.6 提升,並已能與 Fable 5.1、GPT-6 Astra 等其他前緣模型表現相當。
資安與安全防護:全新防護堆疊,HackerBench v0.3 拿下最高分
xAI 表示,Grok 4.7 搭載了全新設計的安全防護堆疊,是該公司目前測試過在「拒絕不當請求」與「抵抗越獄攻擊」方面表現最強的模型。在資安與生物領域這類「雙重用途」敏感領域,官方宣稱 Grok 4.7 同時在「協助正常合法任務」與「拒絕危險請求」兩端都取得領先,在 LatchBio 的生物安全基準測試中拿下 62.4% 的成績,屬於目前測試過的最高分。
在網路資安方面,Grok 4.7 在 xAI 自家設計、用來評估高風險與惡意網路任務的 HackerBench v0.3 測試中拿下最高安全分數,僅有 3.3% 的高風險雙重用途提示被放行,同時盡量避免誤擋一般合法的資安研究工作。xAI 也宣布,已開始邀請部分資安合作夥伴以邀請制方式,搶先使用 Grok 4.7 的紅隊測試能力,用於防禦性資安研究。
定價與開放管道:與 Grok 4.6 同價,多平台同步上線
Grok 4.7 即日起開放使用,除了 xAI 自家的 Grok 產品線之外,也同步透過 API、第三方程式設計工具(coding harness)以及各家模型路由器與雲端平台提供服務。定價方面,官方公布的標準費率為每百萬輸入 token 2 美元、每百萬輸出 token 6 美元,與 Grok 4.6 相同;另外也提供輸出速度加倍、價格同步加倍的高速版本,供對延遲較敏感的應用選用。
先前的外界傳聞:2.1 兆參數與 SpaceX 訓練資料,官方尚未正式證實
Grok 4.7 上線前,外界對其規格已有不少討論。馬斯克本人今年 7 月底曾在個人 X 帳號上表示,Grok 4.7 會是「2.1 兆參數版本」,並提到訓練過程會加入「SpaceX 旗下大量頂尖工程資料(排除受 ITAR 管制的部分)」作為補充訓練素材;不過這些說法目前僅止於馬斯克個人帳號發言,xAI 官方發布頁面並未公布具體參數量,也未提及 SpaceX 資料的訓練細節,兩者之間的落差值得留意。
更多AI相關報導
- xAI 發表 Grok 4.7:主打程式設計與知識工作效能新王,價格打平 Grok 4.6
- Google Home MCP 開放測試:Claude、OpenClaw 可查家庭紀錄並控制智慧裝置
- OpenAI 公布模型偏離通報框架:六起案例包括隱瞞錯誤、擅用 API 金鑰與越權傳檔
- Anthropic 合併 Claude Chat 與 Cowork:Claude Docs、Slides 直接在對話中共同編輯
- Google 發布 Gemini 3.8 Live:語音對語音指數 82.6 登頂,邊說邊推理與呼叫工具