
在 AI 模型軍備競賽進入白熱化的階段,各家廠商都在爭奪那微小的跑分差異。最近 Anthropic Opus 的 “降智” 讓很多人在猜 Opus 4.7 即將推出,果不其然 ——全新旗艦模型 Claude 4.7 Opus 來了!不僅在基準測試(Benchmark)上交出輾壓級的亮眼成績單,更將這些冰冷的數據,完美轉化為「長文本深度推理」與「自主代理(Agentic Workflow)」的實用商業價值。
對於企業與進階工作者來說,Claude 4.7 Opus 已經超越了單純的「文字生成工具」,而是準備好成為你團隊中那位思考縝密、能自主解決問題的「超級數位員工」。
跑分只是基本盤:深入骨髓的「深度推理」能力
過去我們在使用大型語言模型(LLM)時,最怕遇到的就是「幻覺」或是面對複雜邏輯時的「一本正經胡說八道」。Claude 4.7 Opus 透過全新的架構設計,大幅強化了數學邏輯與程式碼的推理能力。
這意味著什麼?當你丟給它數萬行的專案程式碼,或是連續十年的企業財務報表時,它不僅能一口氣吞下高達一百萬 Token 的龐大資訊,還能精準地在不同段落間建立邏輯關聯。它能告訴你「這段程式碼的修改為何會導致另一個模組報錯」,而不僅僅是表面上的語法除錯。
很多人會問:「模型跑分再高,對我的日常工作有什麼幫助?」Claude 4.7 Opus 這次在三大核心基準測試的突破,正好對應了現代職場最需要的高階能力:
- GPQA (研究所級別的 Google 防弊問答) 創下新高 —— 你的「專家級智庫」: GPQA 是一項連擁有博士學位的人類專家都覺得困難的測試。Claude 4.7 Opus 在這項測試中的大幅領先,意味著它在處理法律合約分析、醫學文獻解讀、或是複雜金融法規時,具備了極高的專業準確度。它不再只會給出空泛的建議,而是能像真正的產業顧問一樣,提供具備深度與洞察力的專業見解。
- HumanEval (程式碼生成與除錯) 突破天際 —— 你的「資深架構師」: 在考驗程式邏輯的 HumanEval 測試中霸榜,代表 Claude 4.7 Opus 的能耐早已超越了寫寫簡單的 Python 腳本。當你丟給它數萬行的專案程式碼時,它不僅能一口氣吞下高達一百萬 Token 的龐大資訊,還能精準找出隱藏在深處的 Bug,甚至為你重構整個模組的架構。它能清楚告訴你「這段程式碼的修改為何會導致另一個 API 報錯」,這是許多初階工程師都難以做到的事。
- MATH (進階數學推理) 穩定領先 —— 你的「精準數據分析師」: 數學推理能力是 AI 是否會產生「幻覺」的關鍵指標。Claude 4.7 Opus 在數學與邏輯推演上的強化,讓企業可以放心將連續十年的財務報表、或是複雜的市場動態定價模型交給它處理。它能精準地在不同數據段落間建立邏輯關聯,並產出經得起驗證的財務預測報告。
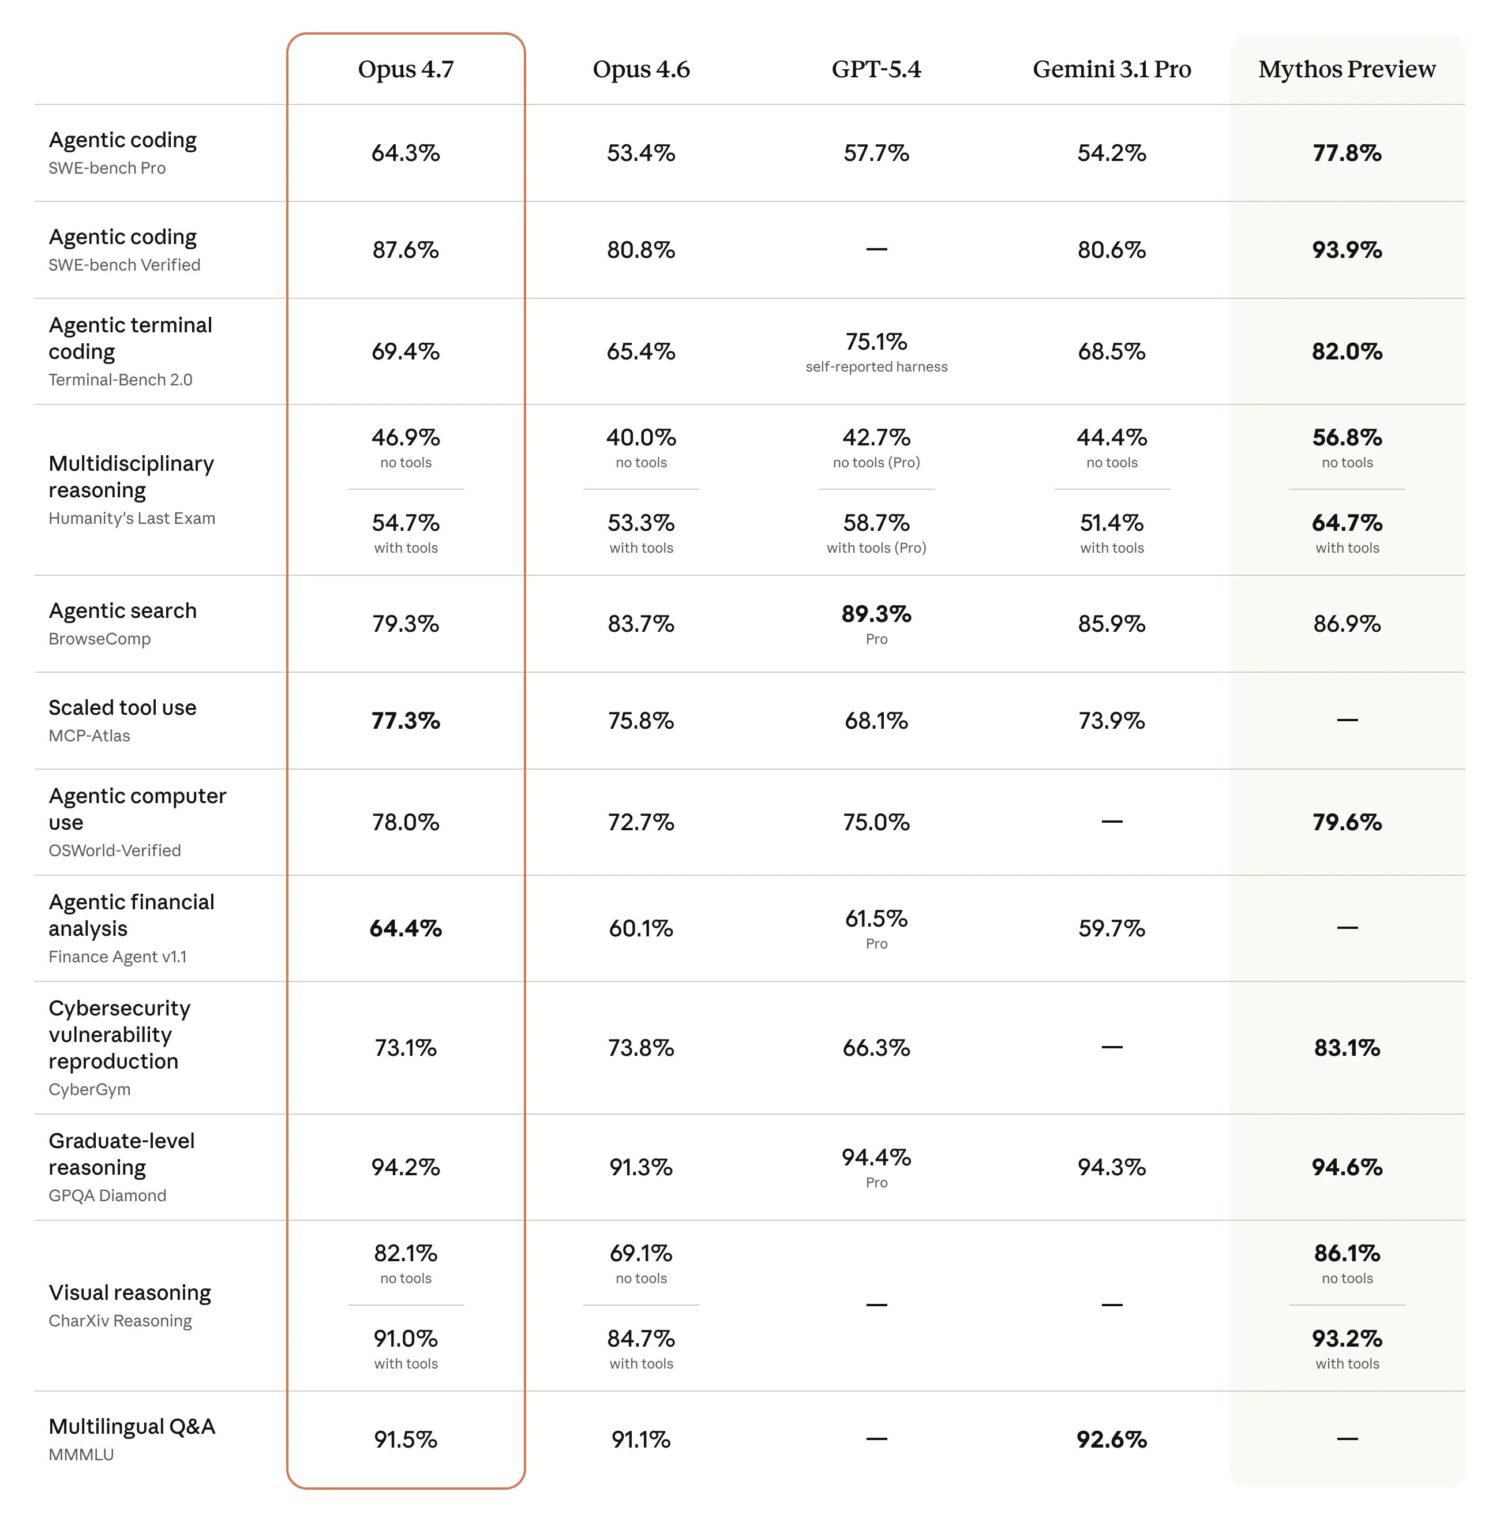
代理能力大爆發:從「一問一答」到「全自動執行」
建立在上述強大的推理與運算基礎上,這次更新最讓開發者與商業用戶興奮的,莫過於 Claude 4.7 Opus 原生強化的「代理能力」。
傳統的 AI 工作流是你下一個指令,AI 給一個動作;但 Claude 4.7 Opus 具備了更優秀的「任務拆解與規劃」能力。你只需要給予一個宏觀的目標(例如:「幫我分析這三份競品報告,抓出核心差異,並寫成一份適合向主管報告的簡報大綱,最後自動發送至指定信箱」),它就能自主將這個大任務拆解成多個小步驟,依序執行並自我驗證結果。這種從「被動問答」到「主動執行」的跨越,將大幅提升企業導入 AI 的投資報酬率。
成本與效能的雙面刃:Token 消耗量預計提升 35%
雖然 Claude 4.7 Opus 帶來了輾壓級的推理與代理能力,但企業與開發者在評估導入時,也必須留意 API 成本結構的微調。根據官方與早期實測數據,在處理相同複雜度的任務時,新模型的 Token 消耗量預計會比以往增加最高 35%。
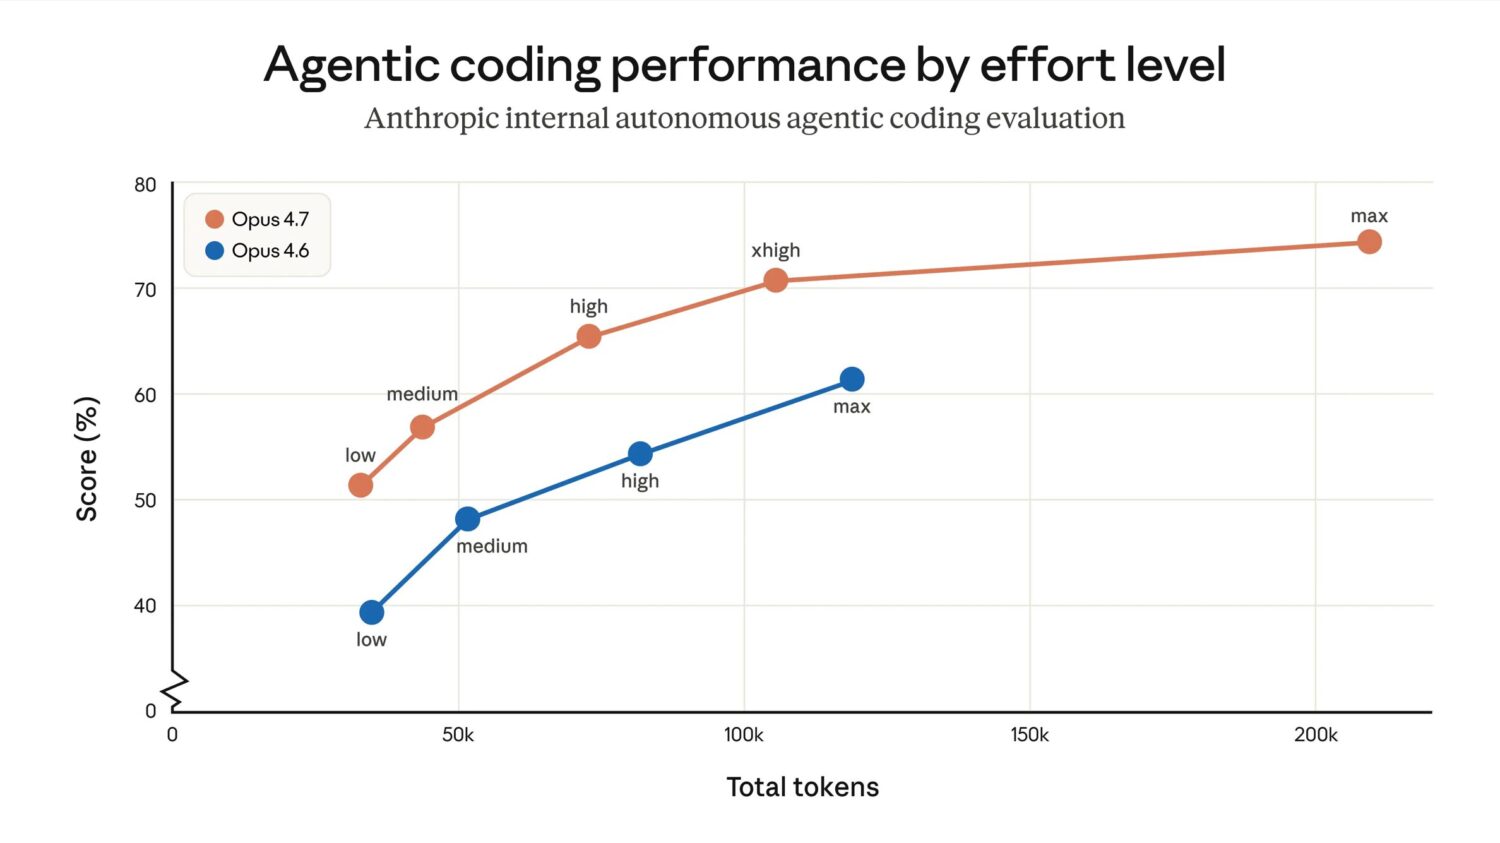
換個角度想,這就像是多付一點預算,要求你的「超級數位員工」在交出報告前再三檢查。對於程式碼重構、跨國法律合約審閱、或是高階財務預測等「容錯率極低、商業價值極高」的核心任務來說,這額外最高 35% 的 Token 投資,換來的是近乎免除錯的高品質產出,絕對是一筆划算的交易。
性價比與生態系的下一步
隨著 Claude 4.7 Opus 的推出,我們可以看到 Anthropic 依然堅守其「安全、可控、高智商」的核心產品定位。雖然旗艦級模型的 API 呼叫成本通常較高,但如果能將其精準應用在需要高階推理、高容錯率的核心商業決策上(例如上述提到的法律、財務與系統架構分析),它所節省下的人力時間與試錯成本,將遠超過 API 的花費。