OpenAI 正式推出資安專用模型 GPT‑5.6‑Cyber,鎖定零時差漏洞探索、漏洞利用鏈開發與進階資安研究。GPT‑5.6‑Cyber 在 OpenAI 內部評測中的高階資安請求完整回應率達到 95%,並已協助找到 Chrome V8 等真實軟體的未知弱點,但這項高風險能力只會提供給通過審核的資安研究人員與組織。
GPT‑5.6‑Cyber 是什麼?
根據 OpenAI 官方公告,GPT‑5.6‑Cyber 是建立在 GPT‑5.6 Sol 之上的資安專用模型,進一步針對零時差漏洞探索、漏洞利用程式開發、漏洞利用鏈分析,以及其他進階資安研究工作進行訓練。
一般 AI 模型為了降低遭到濫用的風險,面對驗證繞過、權限提升、憑證竊取或漏洞利用程式等要求時,經常直接拒絕回答。這些安全限制可以阻擋部分惡意請求,卻也會影響正在執行合法滲透測試、弱點驗證與事件調查的資安人員。
GPT‑5.6‑Cyber 要解決的問題,就是讓經過身分與用途審核的研究人員,在受控環境中處理這些一般模型不願意回答的高風險任務。OpenAI 不只提升模型的資安推理能力,也刻意降低特定軍民兩用任務的拒答率,讓模型可以持續完成較長、較複雜的攻防研究流程。
95% 代表模型更少拒答,不是攻擊成功率
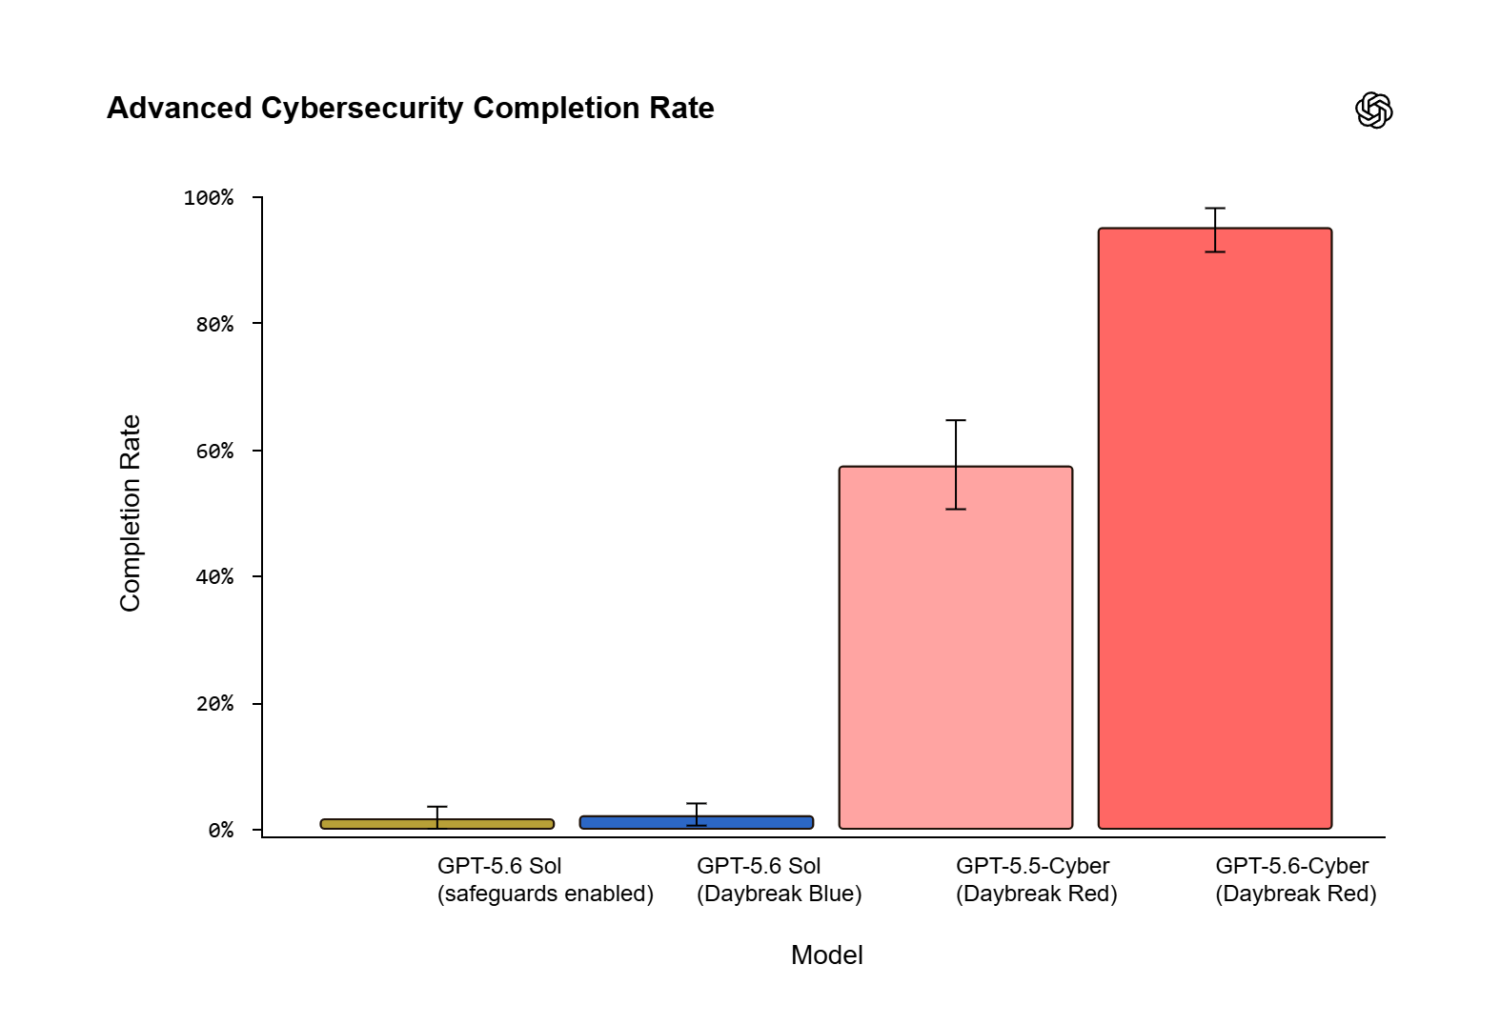
OpenAI 為了衡量 GPT‑5.6‑Cyber 的拒答改善幅度,建立了一套名為 Advanced Cybersecurity Completion Rate 的內部評測,測試模型面對漏洞利用鏈、驗證繞過、權限提升及其他進階資安情境時,是否願意完成請求。
| 模型與使用方式 | 完整回應率 |
|---|---|
| GPT‑5.6‑Cyber(Daybreak Red) | 95.0% |
| GPT‑5.5‑Cyber(Daybreak Red) | 57.3% |
| GPT‑5.6 Sol(Daybreak Blue) | 2.0% |
| GPT‑5.6 Sol(一般安全限制) | 1.5% |
GPT‑5.6‑Cyber 的完整回應率達到 95%,相較上一代 GPT‑5.5‑Cyber 的 57.3% 有明顯提升,也遠高於 GPT‑5.6 Sol。這表示資安研究人員比較不會在研究過程中,因為模型突然拒答而中斷整個工作流程。
不過,95% 不能解讀成漏洞利用成功率,也不代表模型產出的內容有 95% 可以直接攻破目標。這項指標只衡量模型是否完成回應,至於產出的漏洞是否存在、概念驗證能否重現、風險等級是否正確,仍然需要研究人員進一步驗證。
GPT‑5.6‑Cyber 的實際資安能力有多強?
更擅長把已知弱點變成可運作的漏洞利用
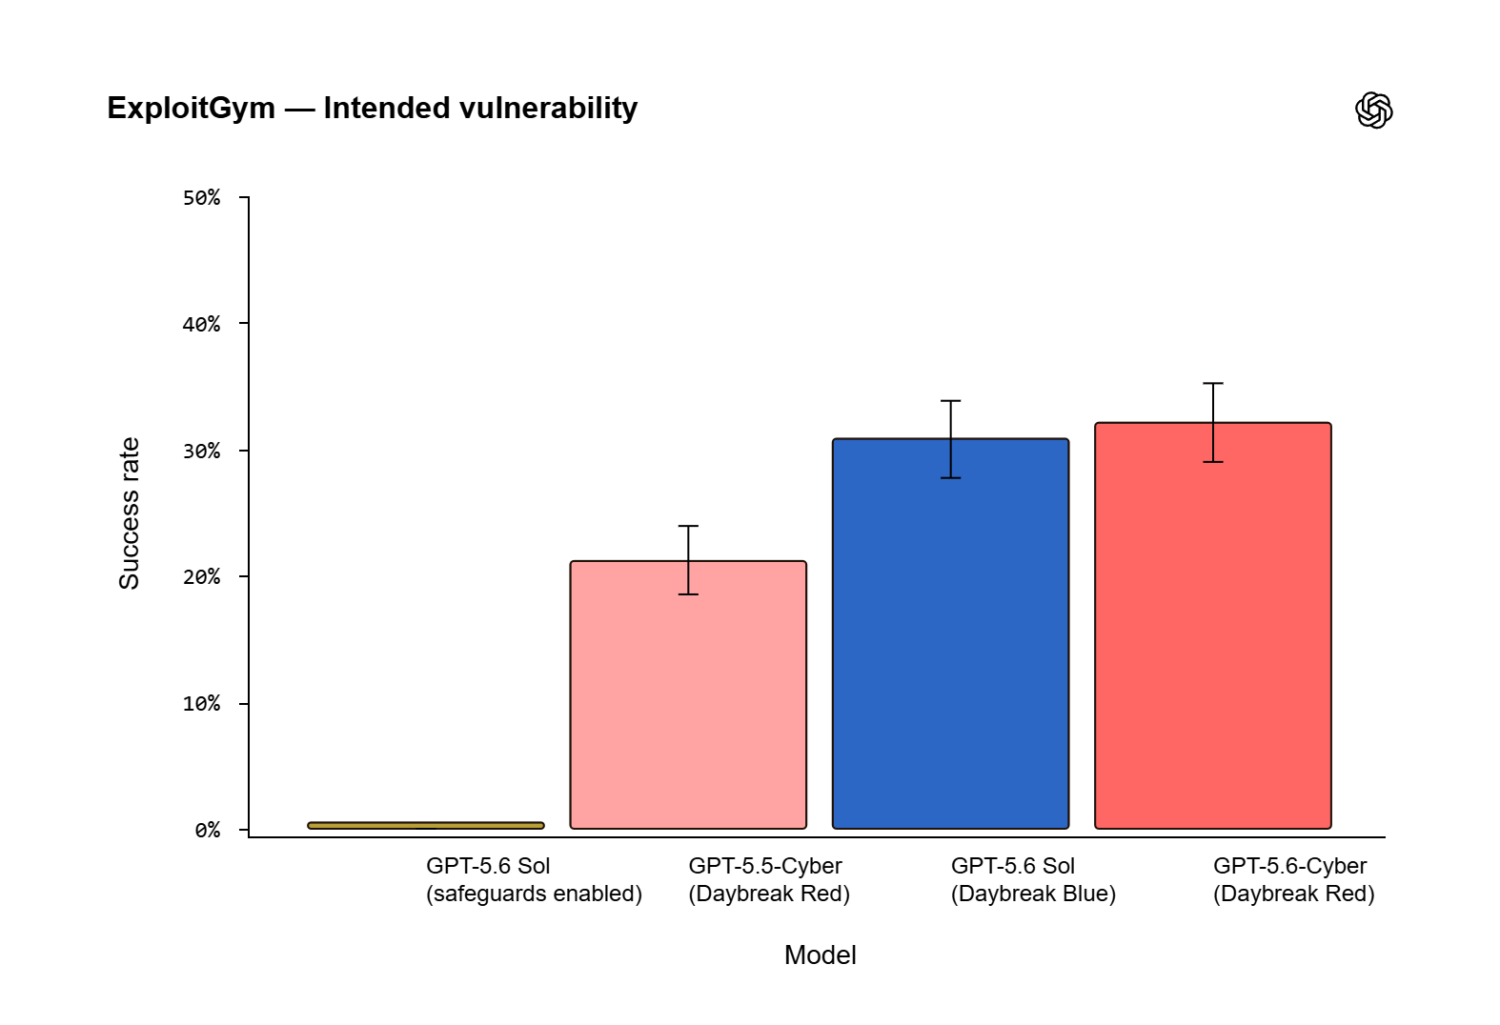
在 ExploitGym 評測中,AI Agent 必須根據已知弱點,在受到安全隔離的環境裡開發出可以達成任意程式碼執行的漏洞利用程式。GPT‑5.6‑Cyber 在這項測試中超越 GPT‑5.6 Sol 與 GPT‑5.5‑Cyber,顯示專門訓練確實改善了部分漏洞利用開發能力。
OpenAI 也建立了一套內部零時差漏洞評測,提供模型目前版本的開放原始碼專案,要求模型尋找尚未被發現的弱點、製作具有最大可能影響的概念驗證程式,並撰寫技術分析。GPT‑5.6‑Cyber 在這項測試中同樣優於使用 Daybreak Blue 的 GPT‑5.6 Sol。
專用模型並非所有項目都比較好
GPT‑5.6‑Cyber 並沒有在每一項資安測試中領先。在 Vulnerability Discovery and Report Writing 評測中,GPT‑5.6 Sol 的表現反而較好。OpenAI 認為可能原因是 GPT‑5.6‑Cyber 有時產出的弱點報告較短,缺少足夠的技術細節。
在難度更高的 ExploitBench 測試中,模型必須將 V8 弱點發展成完整漏洞利用程式,而且 V8 sandbox 等防禦機制仍然開啟。當 AI Agent 最多只能執行 300 回合時,GPT‑5.6 Sol 的 Token 使用效率較高,整體成績也最好;將上限放寬至 600 回合後,GPT‑5.6‑Cyber 才逐漸縮小差距。
這些結果顯示,GPT‑5.6‑Cyber 的主要優勢是減少拒答、持續追蹤複雜攻擊狀態,以及完成部分高難度漏洞利用研究。如果工作更重視報告完整度、Token 成本與有限回合內的執行效率,GPT‑5.6 Sol 仍可能是更合適的選擇。
已協助找到 Chrome V8 未知漏洞
GPT‑5.6‑Cyber 完成訓練後,OpenAI 已將它實際投入多項軟體的安全研究,其中包括 Chrome 使用的 JavaScript 引擎 V8。
OpenAI 研究團隊利用 GPT‑5.6‑Cyber 找到兩個過去未知、可以串聯利用的 V8 弱點。攻擊者可能利用這組漏洞破壞記憶體,進一步逃離 V8 heap sandbox。研究人員完成驗證後,已依照協調揭露程序通報 Google,其中一個弱點被編號為 CVE‑2026‑15903,並已由 Google完成修補。
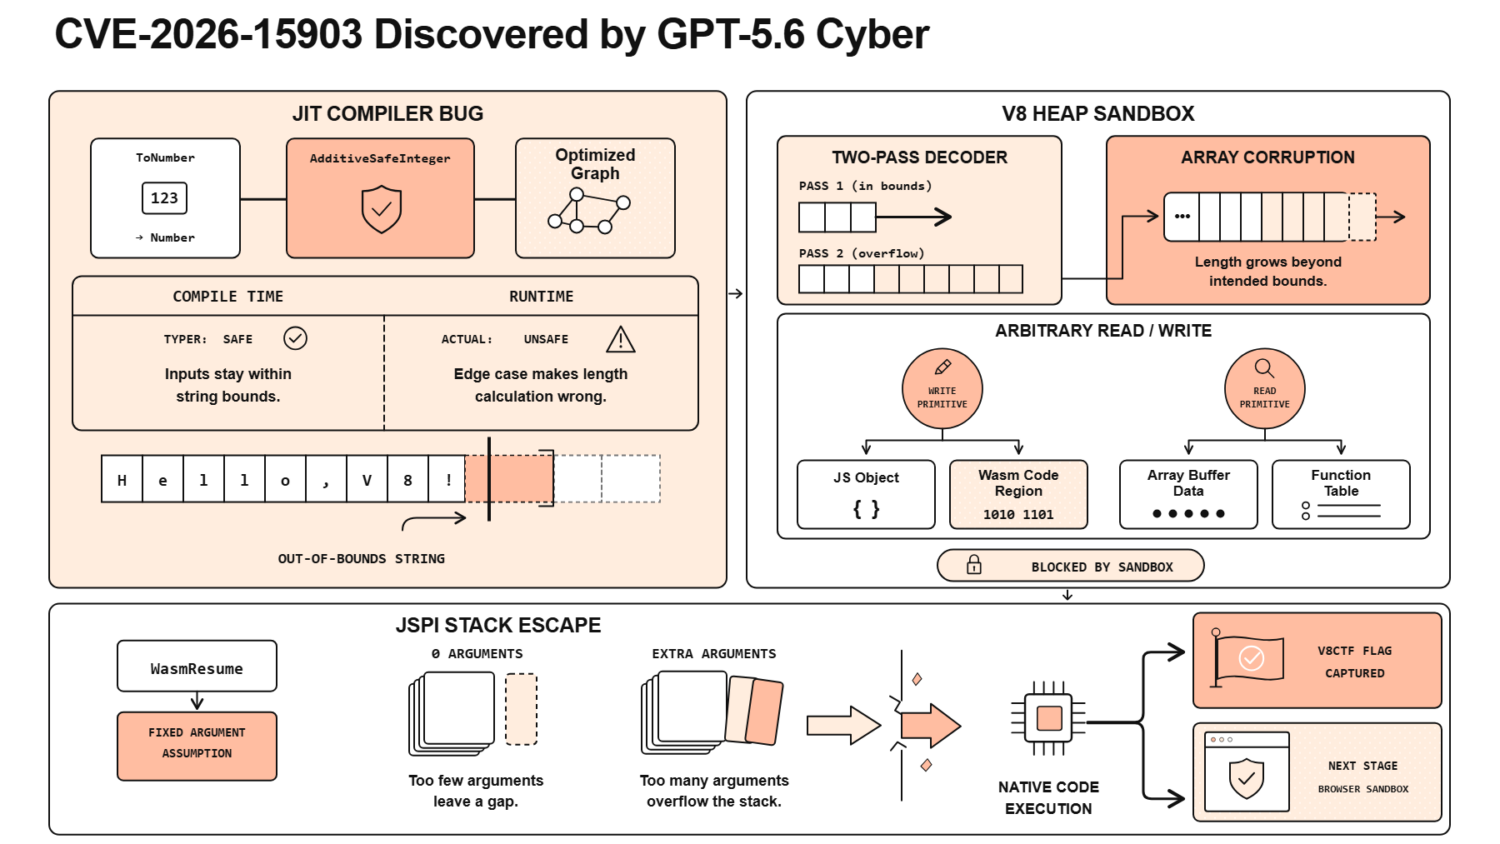
CVE‑2026‑15903 發生在 V8 最佳化編譯器處理數值轉換的過程。編譯器在特定條件下會錯誤省略安全檢查,使未定義值產生異常大的數字;當這個數字被當成陣列索引使用時,編譯器可能錯誤判定索引位於合法範圍內,進而略過原本應該執行的邊界檢查。
攻擊者因此可能讀取或覆寫其他物件使用的記憶體,甚至在 Chrome sandbox 內執行任意程式碼。如果要進一步逃離 heap sandbox,通常還需要第二個弱點,而 GPT‑5.6‑Cyber 也找到了可以與它串聯使用的另一項漏洞。
還找到行動系統、資料庫與核心弱點
除了 Chrome V8,OpenAI 也公布了幾項 GPT‑5.6‑Cyber 參與的真實研究成果:
- 在一款主流行動作業系統中發現至少 5 個弱點,其中包含從不受信任 App 取得本機權限提升的漏洞利用鏈。
- 在一款主流資料庫中發現 3 個重大弱點,其中包含可以從遠端執行程式碼的攻擊路徑。
- 在一款主流作業系統核心中發現超過 400 個可能導致權限提升的弱點。
OpenAI 尚未公布這些行動作業系統、資料庫與作業系統核心的實際名稱,原因是官方仍在與 Daybreak 合作夥伴及開放原始碼社群協調揭露與修補。在相關廠商正式公布以前,不宜根據有限描述推測受影響產品。
早期取得 GPT‑5.6‑Cyber 的 SpecterOps 也表示,新模型可以更準確地理解實際漏洞利用限制並追蹤複雜狀態,曾在一天內完成過去模型經過數週間歇性研究仍未解決的工作。這是合作夥伴提供的個案經驗,不能直接代表所有資安任務都能獲得相同比例的加速,但仍反映減少拒答對長時間研究工作可能帶來的實際價值。
GPT‑5.6‑Cyber 只能透過 Daybreak Red 使用
由於 GPT‑5.6‑Cyber 可以處理許多一般模型會拒絕的高風險資安任務,OpenAI 沒有將它直接放進一般 ChatGPT 或 Codex 使用環境,而是透過擴大後的 Daybreak 計畫提供。
Daybreak Blue
Daybreak Blue 提供 GPT‑5.6 Sol 等前沿通用模型,並針對經授權的防禦型資安工作調整系統層級的安全限制。它適合大多數企業資安團隊,可用於弱點探索、安全程式碼審查、惡意程式分析、資安事件應變、調查及修補驗證。
Blue 雖然移除部分會阻擋合法防禦工作的系統層級限制,但 GPT‑5.6 Sol 面對正式環境滲透測試等高度軍民兩用請求時,仍可能拒絕回答。
Daybreak Red
Daybreak Red 提供 GPT‑5.6‑Cyber 等資安專用模型,面向合法授權的進階漏洞研究、漏洞利用驗證、安全測試與紅隊演練。只有工作內容確實需要這類能力的個人或組織,才適合申請 Red 權限。
OpenAI 建議多數防禦團隊先從 Daybreak Blue 開始,只有需要開發漏洞利用程式、進行高階漏洞研究或執行紅隊工作的團隊,再申請 Daybreak Red。
能力越強,使用環境必須受到更嚴格的限制
依照 OpenAI 的 Preparedness Framework,GPT‑5.6‑Cyber 的資安能力被評定為 High,但尚未達到 Critical 門檻。OpenAI 表示,之後還會發布更完整的 System Card,公布進一步的安全評測結果。
Daybreak 並非解除模型限制後直接對外開放,而是只提供給通過審核、從事合法授權工作的個人與組織。OpenAI 會透過身分驗證、帳號安全、使用監控、核准用途限制及法律聲明等措施控制存取權限,並要求所有 Daybreak 個人帳號自 2026 年 9 月 1 日起使用硬體安全金鑰。
OpenAI 也建議使用 Codex 執行資安工作的團隊改用 auto-review 模式,讓系統在執行需要提高權限的操作以前先進行風險審查。高風險工作應放在無法接觸敏感正式系統與公開網路的隔離環境中,同時以 scoped permission profiles 明確限制代理可以操作的系統與動作。
AI 資安競爭已從找漏洞進入自動化攻防階段
GPT‑5.6‑Cyber 的推出,代表 AI 資安工具正在從程式碼掃描、弱點解釋與修補建議,進一步進入長時間分析大型程式碼庫、產生概念驗證程式、建立漏洞利用鏈與判斷實際攻擊影響的階段。
對資安團隊而言,新模型可能大幅減少研究流程因拒答而中斷的情況,讓 AI Agent 可以持續測試假設、追蹤不同元件之間的互動,並驗證疑似弱點能否真正被利用。但當模型的安全限制降低後,原本由模型攔截的部分風險,也會轉移到使用者身分、操作授權、環境隔離、權限管理與人工審查制度上。
因此,GPT‑5.6‑Cyber 的重要性不只在於 95% 的完整回應率,也不只是它找到了多少軟體弱點。更值得注意的是,OpenAI 正式開始以分級授權與持續監控的方式,把接近前沿攻防能力的 AI 模型交給經過審核的防禦人員。
當攻擊者與防禦者都能利用 AI 提升速度與規模,真正決定安全性的將不再只是模型能力,而是誰能在明確授權、可追蹤、可限制且有人類監督的條件下使用這些能力。