輝達 (nVidia) 於 COMPUTEX 2026 期間,正式對外公開專為新世代 Windows AI PC 打造的超級晶片「RTX Spark」。在生成式 AI 應用逐漸從雲端走向終端設備的趨勢下,RTX Spark 透過整合強大的圖形運算力與高容量統一記憶體,為開發者與專業創作者提供了一個無須妥協的行動運算平台。
NVIDIA RTX Spark 是什麼?
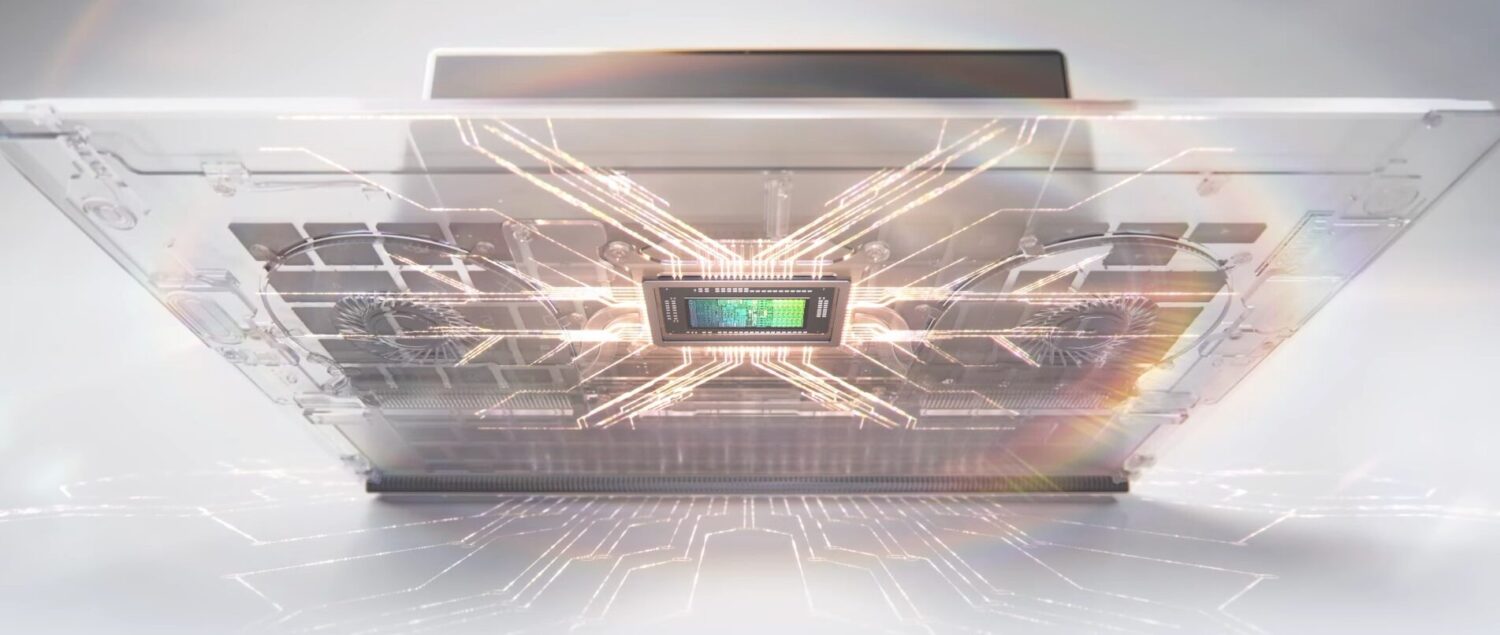
簡單來說,NVIDIA RTX Spark 是輝達專為次世代 AI 筆電打造的「超級晶片 (Superchip)」。它打破了過去筆電 CPU 與 GPU 必須分開獨立運作的傳統架構。
這款晶片採用台積電 3 奈米先進製程,將輝達引以為傲的 Blackwell 架構 RTX 顯示晶片,與聯發科 (MediaTek) 攜手打造的 20 核心 Grace CPU,透過獨家 NVLink 技術直接封裝在一起。這樣的設計不僅大幅縮減了主機板佔用空間,讓筆電能維持輕薄,更重要的是創造出極高頻寬的「統一記憶體」架構。對於消費者與企業而言,RTX Spark 的誕生意味著你不必再依賴雲端伺服器來處理複雜的 AI 生成或 3D 運算,這顆晶片能直接在筆電本機端提供高達 1 Petaflop 的算力,真正實現隨處皆可運算的高效工作流。

跨越架構藩籬:Arm CPU 與 Blackwell GPU 的深度整合
為了在輕薄筆電的有限空間與散熱條件下發揮最大效能,NVIDIA 在 RTX Spark 的架構設計上進行了深度優化。中央處理器方面,NVIDIA 選擇與聯發科攜手合作,開發出具備 20 核心的 Arm 架構 Grace CPU,以確保系統在處理日常任務時具備極佳的能源效率。
而在核心的圖形與 AI 運算上,則搭載了最新的 Blackwell 架構 RTX GPU,內建高達 6144 個 CUDA 核心,整體圖形效能約等同於筆電版的 RTX 5070。為了讓兩者協同工作,NVIDIA 導入了 NVLink-C2C 技術,讓 CPU 與 GPU 之間的資料傳輸頻寬大幅提升。這樣的設計邏輯,讓筆電在維持低功耗的同時,也能瞬間爆發出驚人的 AI 算力,足以應付複雜的代理式 AI (Agentic Workflows) 運算需求。
128GB 統一記憶體:打破筆電、本機 AI 運算瓶頸
過去,開發者若要在筆記型電腦上運行大型語言模型,往往會受限於獨立顯示卡有限的 VRAM 容量。RTX Spark 徹底改變了這個限制,其最高支援 128GB 的 LPDDR5X 統一記憶體,頻寬高達近 300GB/s。
而為了讓聯發科設計的 Arm 架構 CPU 與 Blackwell GPU 能夠無縫協同工作,NVIDIA 導入了 NVLink-C2C 技術。這條高達 600GB/s 的超高速橋樑,讓處理器之間的資料交換幾乎零延遲,在維持低功耗的同時,能瞬間提供強大的 AI 算力,應付複雜的代理式 AI (Agentic Workflows) 運算需求。
採用統一記憶體架構的優勢在於,CPU 與 GPU 不再需要各自維護獨立的記憶體池,GPU 可以直接存取這高達 128GB 的系統記憶體。這帶來的直接效益是,開發者能夠在筆電本機端載入並運行高達 120B 參數的超大型 AI 模型。這不僅省去了將資料上傳至雲端 API 所產生的延遲與鉅額花費,更能讓企業在完全斷網的環境下處理機密數據,大幅提升了資料安全性與開發彈性。
創作者與開發者的實質工作流升級
在實務應用層面,強大的硬體規格最終必須轉化為工作流的效率提升。受惠於 RTX Spark 的強大算力,影音創作者能夠在 Adobe Premiere 等軟體中,流暢進行 12K 4:2:2 規格的影片剪輯,並加速 AI 去背與特效渲染。
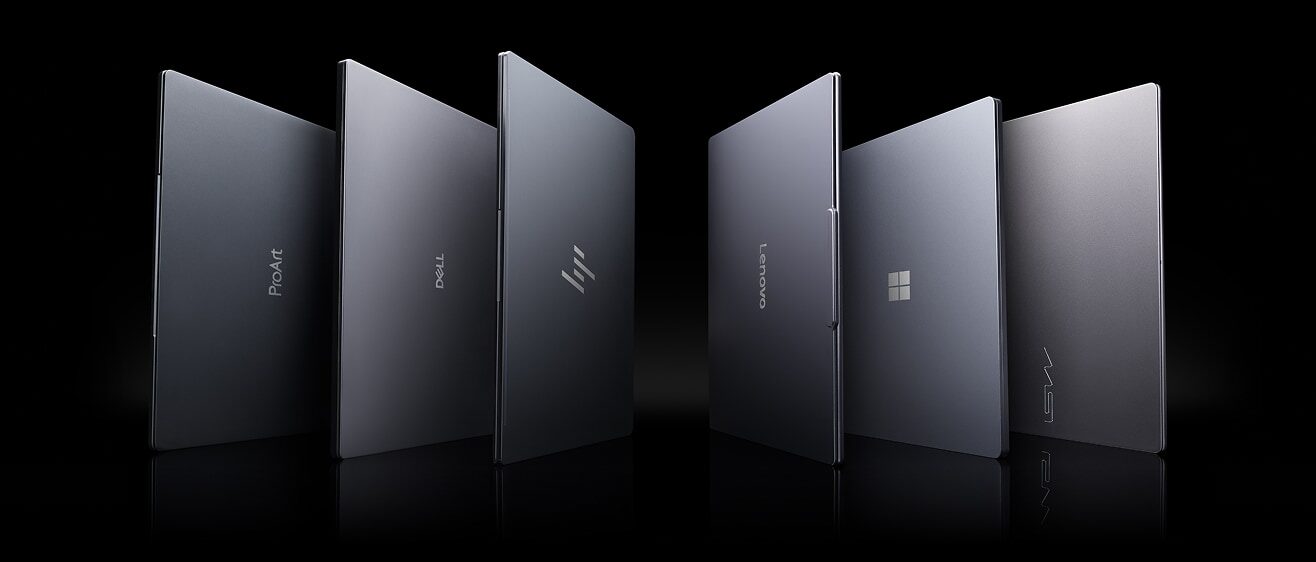
更難得的是,這些強悍的硬體規格全數封裝在極度輕薄的機身內。根據 NVIDIA 的參考設計,搭載 RTX Spark 的筆電厚度最薄可達 14 公釐,重量僅約 1.36 公斤。這讓專業工作者不再需要為了效能而忍受厚重的行動工作站,真正實現了算力與便攜性的完美平衡。
RTX Spark 核心技術規格總覽
| 規格項目 | 詳細參數 | 應用優勢 |
| 超級晶片架構 | 整合式 CPU + GPU | 節省主機板空間,實現極致輕薄機身設計 |
| 晶片互連頻寬 | 600GB/s (NVLink-C2C) | CPU 與 GPU 極速交換資料,解決內部通訊瓶頸 |
| 記憶體支援 | 最高 128GB LPDDR5X 統一記憶體 | 打破 VRAM 限制,本機直接載入 120B 大型模型 |
| 記憶體頻寬 | 最高近 300GB/s | 傳統 DDR5 雙通道的三倍以上頻寬 |
| 綜合 AI 算力 | 1 Petaflop (FP4 精度) | 滿足複雜代理式 AI 工作流,告別雲端 API 花費 |