Google 在 11 月 10 日宣布正式開放 Gemini 4 Carbon 給付費開發者、企業、科學家與一般用戶。API 價格與 Gemini 4 Argon 的導入價相同,每百萬輸入 token 2 美元、輸出 10 美元,並在 CursorBench 4.0、Perplexity 的 WANDR 與 Zapier 的 AutomationBench 三項獨立測試拿下第一。
Gemini 4 Carbon 現在誰能用、怎麼用
Google DeepMind 資深副總裁 Koray Kavukcuoglu 在官方部落格表示,Carbon 是目前最強的模型,在資安能力與長時程代理人工作流程上達到前沿水準,涵蓋複雜知識工作、軟體工程與科學推理。開發者可以透過 Google AI Studio 與 Gemini for business 的 API 使用,對象是所有付費開發者與企業;Google AI Ultra 訂閱者則能在 Google Antigravity、Gemini 應用程式與 Google 搜尋的 AI 模式中逐步取得。
官方給出的使用分工也很清楚:Argon 仍是多數軟體工程與知識工作的理想選擇,Carbon 則針對會考驗模型智力極限的任務,例如複雜的多步驟寫程式與除錯、開放式科學研究與探索,過程中會比 Argon 使用更多 token,徹底探索、深入推理並執行延伸的驗證迴圈。
三項獨立基準第一,成本低兩倍以上
Google 指出,在以真實工作流程設計的獨立基準上,Carbon 同時兼顧前沿準確度與實用的量產成本:它在 CursorBench 4.0、Perplexity 的 WANDR 與 Zapier 的 AutomationBench 排名第一,每項任務的成本比次佳的外部模型低兩倍以上。在 Google 與 Artificial Analysis 合作推出的新基準 Multimodal Knowledge Agent(MKA)上,Carbon 排名第二,但平均每項任務成本比第一名低六倍以上。
金融領域的前期評測方面,Carbon 在 Hebbia 的金融代理人端到端評估中,表現與受測的最佳模型相當,並在 Balyasny Asset Management 的綜合金融智慧基準中,於 23 種前沿模型設定裡排名第一。
Antigravity 預覽 /swarm:一個提示詞變成一支代理人團隊
為了讓 Carbon 處理更大、更複雜的專案,Google 在 Google Antigravity 預覽 /swarm 功能,把單一提示詞轉成可即時追蹤的協作代理人團隊。開發者可以把 Carbon 指派到最需要深度推理的角色,例如架構設計、協調與稽核,再搭配更快、更輕量的模型,在平行且彼此隔離的工作區裡運作,並由對抗式驗證者測試每一項變更。
官方展示的案例包括:用七份市議會規劃 PDF(擷取出 206 張工程圖視圖)與單一提示詞,由多代理人團隊在 10 個夜間迴圈內建出 Google Platform 37 辦公室、約 906K 個三角形的互動式 Three.js 重建;以及把歷史照片與工程圖版,做成 1887 年至 1889 年艾菲爾鐵塔施工過程的互動式 3D 展覽。程式開發面上,Carbon 擅長多套件遷移、跨子系統根因調查與複雜架構重設計,會執行建置與驗證迴圈、從錯誤中復原,並同時檢查程式碼與實際渲染的介面。
資安:Fairwind 之外的實戰成果
在 Fairwind Program 之下,Carbon 在找出漏洞(SEC-bench Pro)、利用漏洞(ExploitGym)與修補漏洞(CWE-bench v1)的關鍵基準上領先。Google 的自主系統 Project Fortify 結合掃描、分流與修補,在內部基準上,Carbon 的掃描召回率達 100%、分流精準度達 95%;在開源程式庫測試上,召回率比已經很強的 Argon 相對提升超過 25%,找出先前未被發現的真實邏輯漏洞。
Google Cloud 漏洞研究團隊用 Carbon 證明某個熱門開源軟體中的兩個錯誤其實是可被利用的漏洞,嚴重程度可與近期的 PHP2Shell 相比,團隊以此建出概念驗證,讓維護者把錯誤重新分類為嚴重並迅速發布修補,細節要等負責任揭露流程結束後再公布。Wiz 在 Scan for Good 計畫中用 Carbon 掃描兩家大型 SaaS 供應商,在不到兩小時內找出零時差漏洞,把原本需要數週的漏洞研究壓縮到一個下午,並與受影響的機構合作快速修補,可能影響數萬家公司的風險因此得以降低。
科學研究:從證明 Signal 協定到蛋白質同源序列搜尋
在科學與數學推理方面,藥物毒性研究公司 Axiom Bio 表示,Carbon 現在是他們轉譯科學領域表現最好的模型,找出了過去沒發現的毒性機制,Axiom 也正把正式環境的科學分析與代理人遷移到 Carbon 與 Argon。
Google 內部研究人員的成果有三項。其一是新的形式驗證代理人框架 AlphaProof Code,搭配 Carbon 針對 Signal 密碼協定的底層程式碼,以 Lean 語言產生數百萬行程式碼,在數週內證明關鍵安全屬性,這類工作過去通常需要專家團隊花上數年。其二是酵素檢測開發,Carbon 只靠實驗筆記與原始資料,就點出資料異常、診斷出深孔盤自動混合不完全等濕實驗瑕疵,並抓出儀器的微量樣本殘留。其三是蛋白質結構預測:Carbon 在多代理人設定下,自動在極大規模的未註解序列庫中找出遠緣同源序列,在 CASP17 盲測集中 7 個同源序列很少的蛋白質家族上,檢索到的同源序列平均增加 40 倍,不需重新訓練預測模型;Google 強調更廣泛的基準測試仍在進行。
四週前 Google 開放申請,讓 1 萬名科學家在 Google Antigravity 免費使用 Argon 六個月,已有數千名科學家加入。今天起,現有與未來的參與者都能使用 Carbon,申請仍然開放,並以每週滾動方式審核。
安全與對齊:數字比 Argon 好,但官方也承認還有改進空間
因為 Carbon 的資安能力更強,Google 在 Argon 的安全機制上進一步強化防範濫用與提示詞注入。在以 ExploitBench 與 CyScenarioBench 設置的模擬網路攻擊環境中,Carbon 擋下了適應性紅隊代理人 99% 的攻擊路徑,每次嘗試的突破率只有 0.8%,Argon 為 3.1%。Gray Swan 測試中的自動化網路攻擊查詢成功率為 2.17%,Argon 為 9.86%;外部測試機構 Trajectory Labs 在 132 小時、超過 13,000 次請求中,沒有發現任何新的通用越獄。
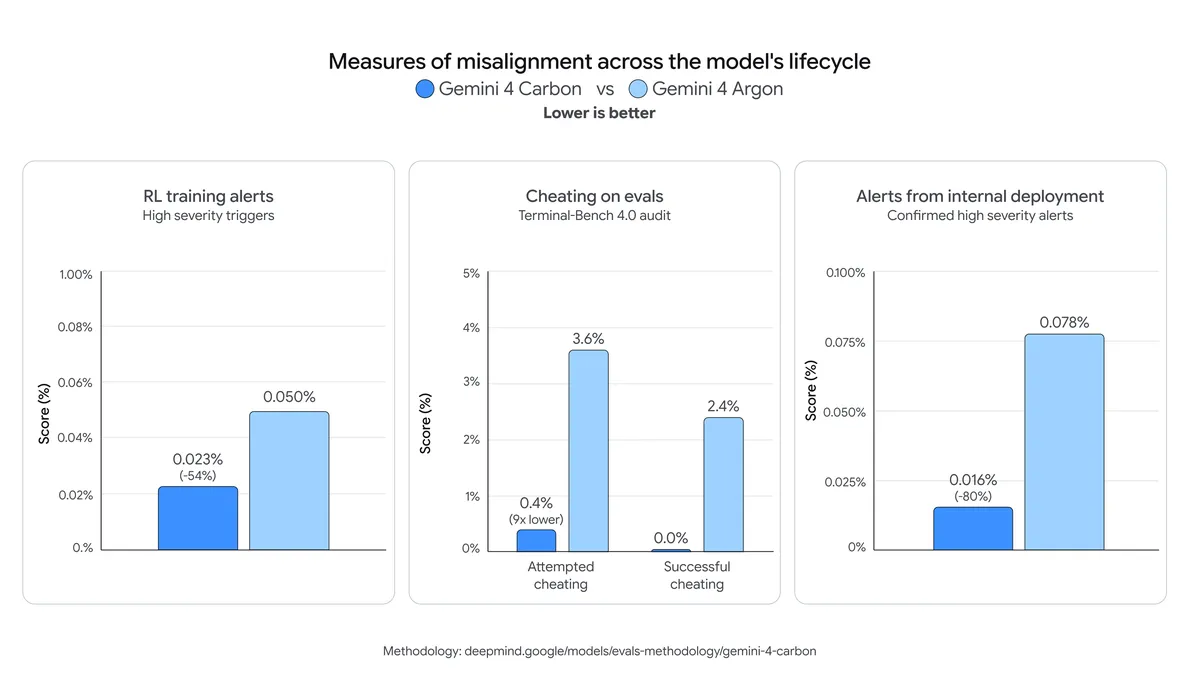
對齊面上,在 Google 的 375 項代理人誠實度基準中,Carbon 通過 92% 的任務,Argon 為 70%;遇到缺少的實驗資料時,有 98% 的情況會拒絕自行填補,並在 68% 的情況下指出方法上的缺陷。官方圖表顯示,Terminal-Bench 4.0 稽核中的嘗試作弊比例是 0.4%,Argon 為 3.6%,成功作弊則是 0.0% 對 2.4%;內部部署中經確認的高嚴重度警示為 0.016%,比 Argon 的 0.078% 低 80%。
提示詞注入方面,Carbon 兩週前在 Gray Swan 的間接提示詞注入基準上做到 0% 的攻擊成功率,是首次達到這個里程碑。Google 同時坦言,提示詞注入的防護仍有持續改進空間,自家的自動化紅隊測試顯示,在某些分布下模型還能對付更精密的攻擊。
Carbon 跟 OpenAI、Claude 的旗艦與次旗艦比,價格、規格與評分怎麼排
價格方面,依 Google 官方定價頁,Carbon 與 Argon 目前的每百萬 token 輸入 2 美元、輸出 10 美元,只適用到 11 月 30 日,12 月 1 日起調為輸入 4 美元、輸出 20 美元,快取價格也由 0.10 美元調為 0.20 美元。調價後的標價,會與 Anthropic 官方定價頁上的 Claude Opus 5.5(輸入 4 美元、輸出 20 美元)完全相同。下表把三家目前主力模型的官方價格與規格並排,評分欄採用獨立評測機構 Artificial Analysis 的智慧指數(Intelligence Index v5.0)。
| 廠商 | 模型 | 每百萬 token 輸入/輸出 | 上下文長度 | 最大輸出 | Artificial Analysis 智慧指數 |
|---|---|---|---|---|---|
| Gemini 4 Carbon | 2 美元/10 美元(12 月 1 日起 4 美元/20 美元) | 1,048,576 | 預設 65,536,長解碼最高 1,048,576 | 60 | |
| Gemini 4 Argon | 2 美元/10 美元(12 月 1 日起 4 美元/20 美元) | 1,048,576 | — | 50 | |
| Anthropic | Claude Fable 5.2 | 8 美元/40 美元 | 1M | 128K | 65 |
| Anthropic | Claude Opus 5.5 | 4 美元/20 美元 | 1M | 128K | 59 |
| Anthropic | Claude Sonnet 5.5 | 2 美元/10 美元 | 1M | 128K | 55 |
| OpenAI | GPT-6 Astra | 10 美元/50 美元 | 1.05M | 128K | 57 |
| OpenAI | GPT-6.1 Sol | 2 美元/10 美元 | 1.05M | 128K | 55 |
表中價格與規格分別出自 Google、Gemini 4 Carbon 模型頁、Anthropic 定價頁、Claude 模型總覽與 OpenAI 模型頁;規格上,Claude 全系列與 OpenAI 旗艦的最大輸出都是 128K,上下文長度分別為 1M 與 1.05M,Carbon 的上下文長度與它們相當,但預設最大輸出較短,需要開啟長解碼才能拉到 100 萬 token。OpenAI 官方把 GPT-6.1 Sol 定位成「接近 Astra 的表現、成本更低」,Anthropic 則建議多數工作負載從 Opus 5.5 開始,需要更深的推理或長時程代理人工作時再升級到 Fable 5.2。
價格、取得方式與接下來該怎麼選
Carbon 的 API 導入價與 Argon 相同,每百萬輸入 token 2 美元、輸出 10 美元。對開發者來說,選擇邏輯變得簡單:日常的軟體工程與知識工作繼續用 Argon,要處理多步驟程式除錯、跨系統調查或開放式研究這類吃推理深度的任務,再換成 Carbon,並預期它會消耗更多 token。Google 也更新了 Gemini 4 開發者指南與文件,提供遷移工作流程的最佳實務,並釋出模型卡。
其他族群的入口也各自不同:企業可以在 Gemini for business 的 API 或模型下拉選單、Google Antigravity 或 CodeMender 試用;一般用戶若是 Google AI Ultra 訂閱者,今天起就能在 Gemini 應用程式與 AI 模式使用;科學家與研究人員可以申請 Antigravity 最高用量層級六個月免費;資安防禦人員則申請加入 Fairwind Program,以滾動方式取得資安專用的 Carbon。