Anthropic 正式發表 Claude Opus 5.5,作為 Claude 5.5 家族的第一款模型,已於 9 月 22 日在所有平台同步上線。這次更新的重點不只是效能提升,官方特別強調在程式撰寫、知識工作與電腦操作能力上都有明顯進步的同時,整體使用成本反而比前一代 Opus 5 便宜了約四成,對於已經大量倚賴 Claude 處理程式與研究工作的團隊來說,是一次值得關注的升級。
Opus 5.5 是什麼?Claude 5.5 家族第一棒
Claude Opus 5.5 是 Anthropic 全新 Claude 5.5 系列中率先亮相的旗艦模型,官方表示這次升級的核心方向鎖定在代理式(agentic)程式撰寫與複雜軟體工作、知識工作與研究、電腦操作與視覺理解,以及提示注入(prompt injection)防禦與對齊能力四大領域。Anthropic 也同步透露,Claude Sonnet 5.5 與 Claude Haiku 5.5 將在未來幾週內接續推出,形成完整的 5.5 世代模型家族。除了能力面的進步,官方特別點出這一代模型在寫作品質上的變化——早期測試者的回饋是「它寫東西的方式,就像是我自己會寫的那樣」,顯示輸出內容在清晰度、組織性與直接程度上都有感提升,這對日常需要用 Claude 產出文件、報告或郵件草稿的使用者來說,會是相對容易感受到的差異。
另外,這也是 Claude 首次以版號對模型產品進行定位,可以遇見未來 Claude 的模型也會有類似 OpenAI GPT-5.6 Sol/Terra 這樣的命名規則,使用者可以一眼看出模型的世代,不會 Opus 自己一個版號、Sonnet 又一個版號,記憶和選擇上會更直觀便利。
Benchmark 全面超車:程式撰寫、知識工作雙提升
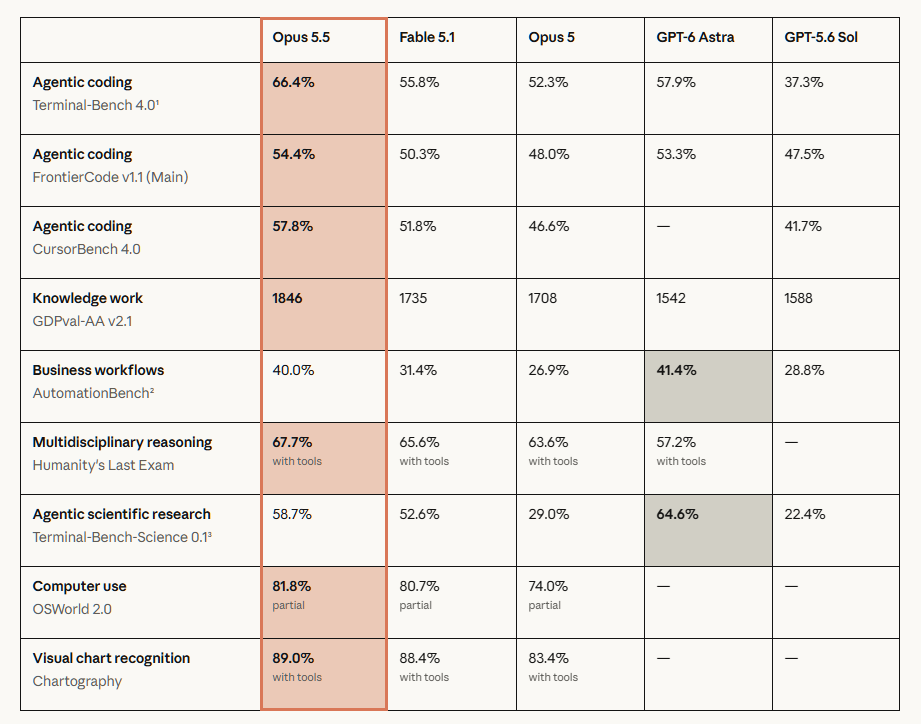
在官方公布的跑分比較中,Claude Opus 5.5 在多項指標上都超越了前代 Opus 5,也贏過對照組模型 Fable 5.1。以終端機操作測試 Terminal-Bench 4.0 為例,Opus 5.5 拿下 66.4%,對照 Fable 5.1 的 55.8% 與 Opus 5 的 52.3%;在前沿程式能力測試 FrontierCode v1.1 上,Opus 5.5 為 54.4%,同樣領先 Fable 5.1 的 50.3% 與 Opus 5 的 48.0%;程式編輯情境測試 CursorBench 4.0 則是 57.8% 對上 51.8% 與 46.6%。至於衡量真實世界知識工作品質的 GDPval-AA v2.1,Opus 5.5 拿下 1846 Elo,也優於 Fable 5.1 的 1735 分與 Opus 5 的 1708 分。整體來看,這一代模型在「動手做事」型的任務(寫程式、操作終端機、處理實際工作流程)上的進步幅度,比單純的知識問答能力提升更為明顯。
效率與定價:算力更省、費用砍 40%
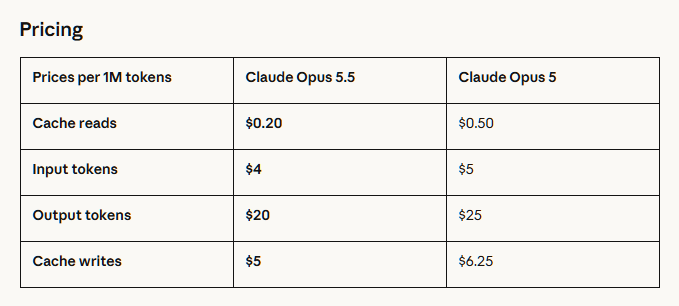
值得注意的是,Opus 5.5 在效能提升的同時,運算資源需求反而下降——官方表示這一代模型完成同樣任務所需的 token 數明顯減少,直接反映在價格上:輸入端從每百萬 token 5 美元降至 4 美元(降幅 20%),輸出端從 25 美元降至 20 美元(降幅 20%),快取讀取費用更是從 0.5 美元大砍到 0.2 美元(降幅 60%)。以典型工作負載換算,官方估計整體使用成本比 Opus 5 便宜約 40%。另外也提供了鎖定速度優先情境的 Fast 模式,輸入輸出價格分別為每百萬 token 8 美元與 40 美元,讓開發者可以依任務性質在成本與延遲之間做取捨。
安全性大幅強化:行為稽核拿下最高分
安全與對齊能力也是這次發表的重點之一。Anthropic 表示 Claude Opus 5.5 在公司內部的行為稽核(behavioral audit)測試中,是目前所有受測模型裡表現最好的一款,嘗試繞過使用邊界(boundary circumvention)的次數比 Opus 5 少了 85%。針對高風險領域,官方也部署了對應的防護機制:資安相關任務設有專屬防護,遇到受限情境會自動退回給 Opus 4.8 處理;生物領域則透過「生命科學驗證計畫」(Life Sciences Verification Program)控管存取權限;模型也內建了針對「保留思考鏈」設計的反蒸餾保護機制,並支援歐盟 AI 法案要求的浮水印標示與零資料保留(zero data retention)選項。這些安全設計呼應了 Anthropic 執行長 Dario Amodei 稍早發表的〈We Must Pace the Frontier〉一文中,主張 AI 能力提升速度應該讓安全實踐同步跟上的立場;官方也提到 Opus 5.5 在上線前經過 Frontier Design 與 METR 兩個外部機構的評估。
實際案例:68 萬行程式碼遷移、C 轉 Rust 都能做
官方也分享了幾個客戶端的實測案例佐證效能提升。其中一位測試者使用 Opus 5.5 在一天之內完成了一項 68 萬行程式碼的遷移工作;在網頁應用程式的載入速度優化測試中,Opus 5.5 達成 40 次任務中 39 次成功改善效能,成功率明顯高於使用 Opus 5 時的表現;另一項將 HAProxy 從 C 語言轉譯為 Rust 的任務,Opus 5.5 在 9.5 小時內完成,且成本比使用 Fable 5.1 低了 51%。此外,在金融分析情境的測試中,也出現 Opus 5.5 主動抓出評估指令本身錯誤的案例,是先前模型版本沒有偵測到的問題,顯示模型在覆核與抓錯細節上的能力也有所提升。這些案例的具體數字均來自 Anthropic 官方公布的測試結果,實際成效仍會因個別工作流程與使用情境而有所差異。
上線時間與後續規劃
Claude Opus 5.5 現已在 Anthropic 旗下所有平台開放使用,並同步支援 AWS、Google Cloud 與 Microsoft Azure 三大雲端服務,開發者可透過 Claude Platform 以模型代號 claude-opus-5-5 直接呼叫。如前所述,Claude Sonnet 5.5 與 Claude Haiku 5.5 將在接下來幾週內陸續推出,屆時 Claude 5.5 家族才會全數到齊;對於目前已經在用 Opus 5 的開發團隊而言,這次「效能提升、成本卻同步下降」的組合,預期會加速既有使用者升級的意願。
Anthropic 官方 Claude Opus 5.5 發表頁面