
生成式 AI 的軍備競賽已經從「模型聰不聰明」延伸到了「模型能記住多少東西」。Anthropic 官方部落格最新宣布,Claude 的 100 萬 Token 上下文視窗(1M Context Window)正式進入 General Availability (GA) 階段。
這不單純只是一個規格上的數字跳動,對於開發者、資料分析師與企業端用戶來說,這更是一個翻新工作流的好機會。
100 萬 Token 能幫你做到什麼?
很多人可能對「100 萬 Token」沒有具體概念。換算下來,100 萬 Token 約等於 75 萬個英文單字,或者數千頁的中文文檔。這代表了什麼?
直接吞下整個專案的原始碼與技術文件
過去寫程式時,如果遇到大型開源專案或跨部門的歷史 Codebase,開發者往往只能「切香腸」式地把程式碼一段段貼給 AI。現在,你可以直接把整個 GitHub Repository、API 說明文件,甚至是長達數十萬行的 Log 紀錄檔,一次性全部倒給 Claude,讓它幫你找出潛在的 Bug 或是撰寫架構分析報告。
跨年份財報與法務文件秒速比對
對於金融與法務工作者,過去 AI 很難處理「跨文件」的深度比對。有了 1M Context,你可以同時上傳一間公司過去 5 年的完整財報、數百頁的併購合約書,請 Claude 直接抓出條款中的矛盾之處,或是總結財務數據的歷年變化。
不只是裝得多,更要找得快:文本索引效能的躍升
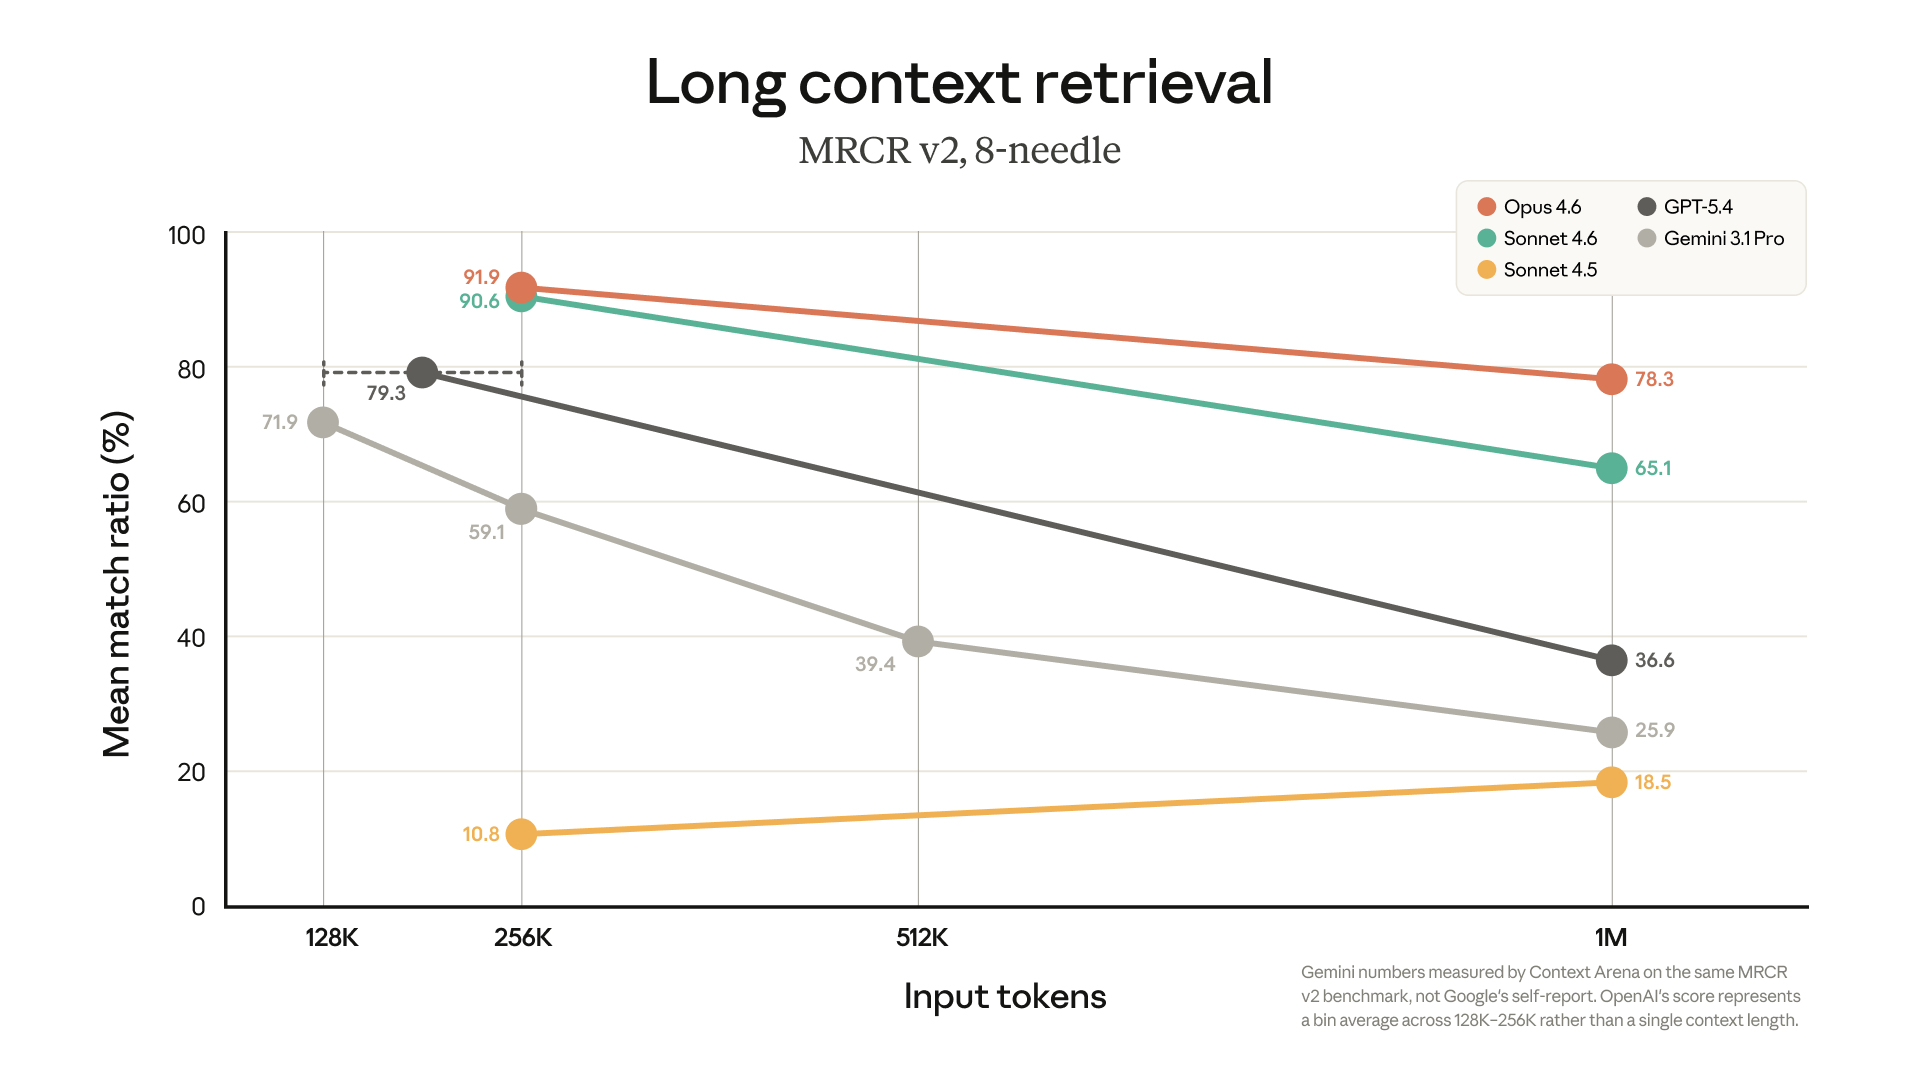
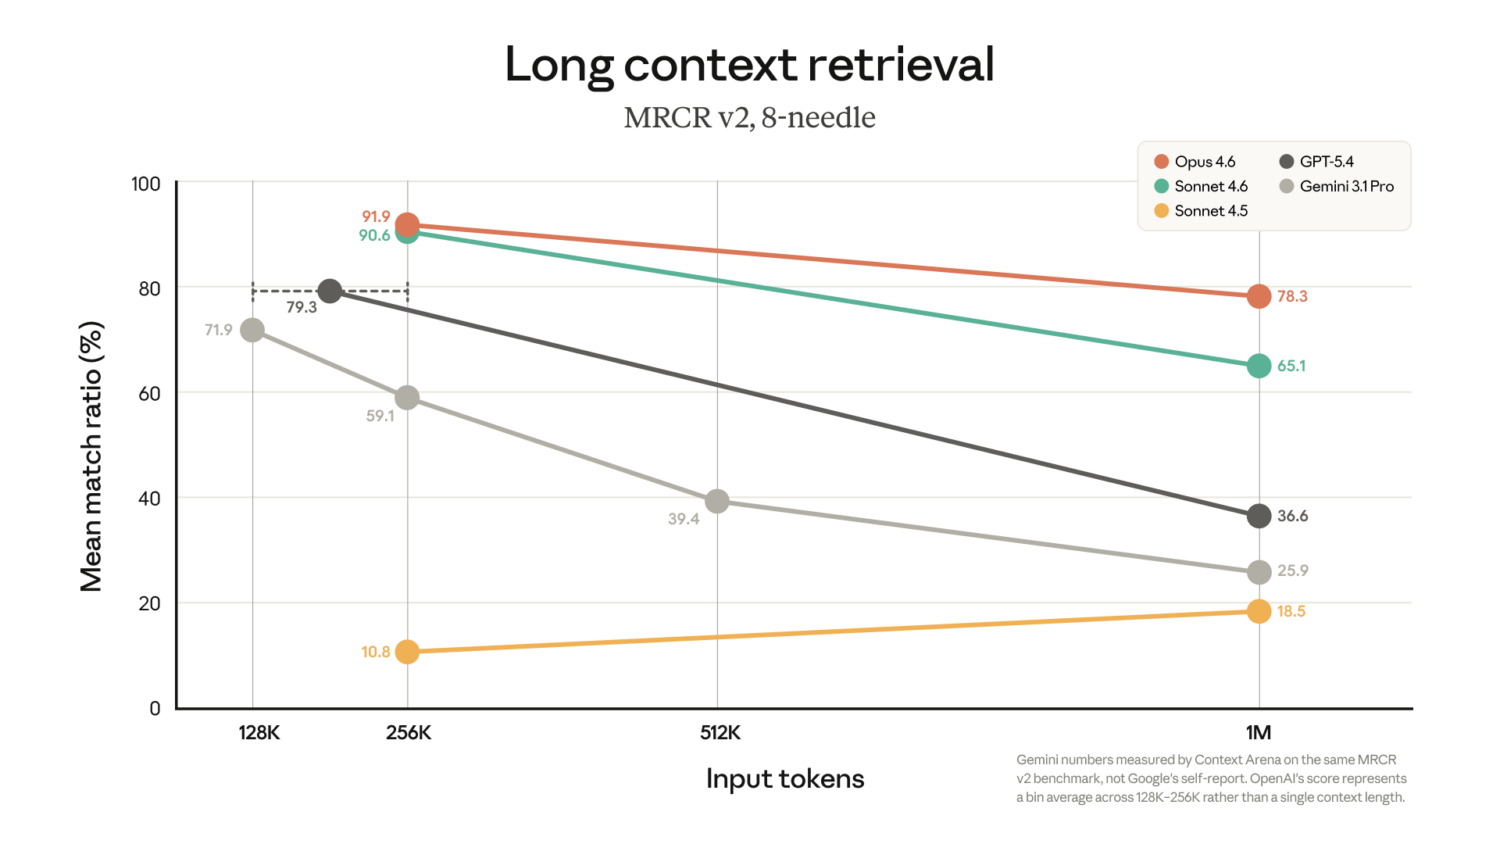
在這次的更新中,最讓開發者興奮的隱藏亮點是文本索引效能(Text Indexing Performance)的優化。
把 100 萬個單字塞進模型是一回事,但要模型在裡面快速找到解答又是另一回事。如果沒有強大的索引效能支撐,超長上下文只會帶來令人崩潰的延遲(Latency)與極高的幻覺率。
索引效能升級帶來的 2 大優勢:
1. 大幅降低首字延遲(Time to First Token):面對數千頁的文件,模型建立內部索引的速度變得更快,能以更短的時間開始吐出分析結果。
2. 精準的「大海撈針」能力:即使關鍵資訊藏在第 80 萬個 Token 的某個小角落,優化後的索引機制也能確保模型精準捕捉,不會因為文本過長而「失憶」或忽略重點。
計費模式與使用限制:效能升級,也要精算成本
天下沒有白吃的午餐,處理 100 萬 Token 所消耗的運算資源是非常驚人的。Anthropic 在這次 GA 公告中,也明確規範了計費模式:
• API 與隨用隨付(Pay-as-you-go)用戶:已經可以全面存取 1M Context 的完整能力,依據實際使用的 Token 量計費。
• Pro、Max 與企業版訂閱用戶:依然享有強大的使用權限,但在單次對話或請求中,只要超過 200K Token 的基準線,系統就會將超出部分視為「額外用量(Extra usage)」並進行計費,而非無限制包含在原本的月費中。
這意味著,雖然規格上看得很爽,但在日常應用中,使用者仍需評估任務的必要性。殺雞焉用牛刀,把 1M Context 留給真正高價值、高複雜度的資料分析任務才是聰明的做法。
RAG 技術會因此被淘汰嗎?
每當模型上下文拉長,就會有「RAG(檢索增強生成)即將消亡」的討論。然而,以目前的商業實務來看,兩者更是互補關係。
1M Context 適合處理「高密集度、需要全局理解」的單次性任務(例如:全盤重構一段舊程式碼)。但如果是企業內部的知識庫客服系統,每次對話都把 100 萬字塞進 Prompt 裡,成本將會極度失控。因此,用 RAG 來精準定位知識片段,在面對極端複雜問題時再輔以 Claude 的長文本能力,將是未來企業 AI 架構的主流作法。
結語
Claude 1M Context 的全面開放,讓原本就已經領先市場的 Claude Opus 獲得更強力的武器,也象徵著 AI 應用正式跨入「海量資料無縫接軌」的時代。對個人工作者而言,省去了繁瑣的資料預處理時間;對企業而言,這開啟了將核心資料庫與 AI 深度融合的大門。建議所有重度 AI 使用者,現在就開始重新審視你的工作流,看看有哪些過去因為「字數限制」而擱置的自動化點子,或許有機會讓它化為真實!