AI 競賽進入白熱化階段,各大廠不僅拼模型的「智力」,現在更要拼「性價比」與「反應速度」。Google 今日正式向開發者與企業釋出了最新一代的 Gemini 3.1 Flash-Lite。這款主打輕量、高速的新模型,不僅是目前 Gemini 3 系列中速度最快、最具成本效益的選擇,更導入了動態思考能力,企圖在效能與運算成本之間取得完美的平衡。
速度飆升 45%,導入「動態思考」機制
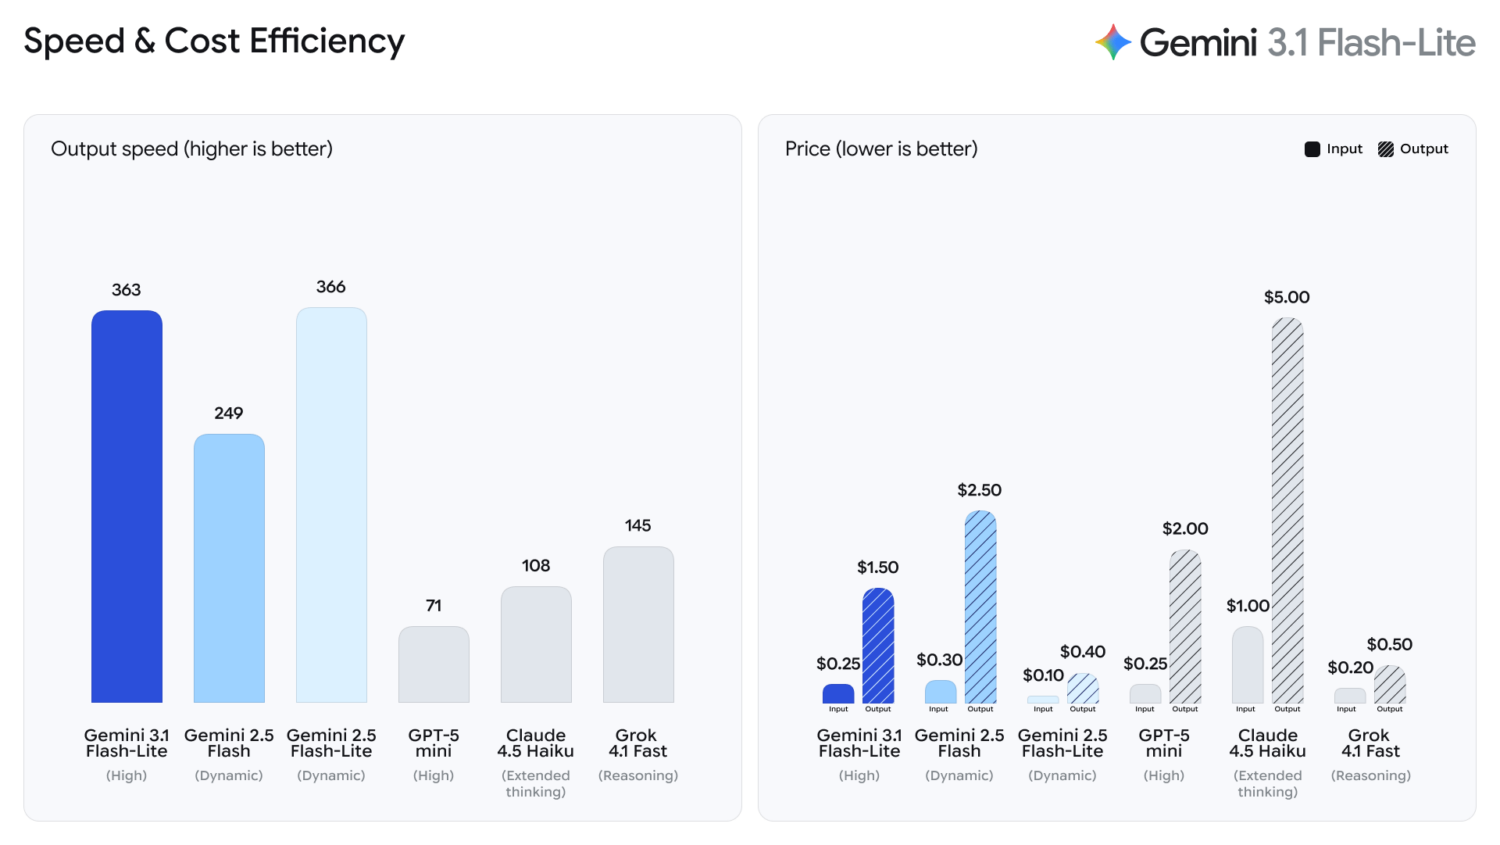
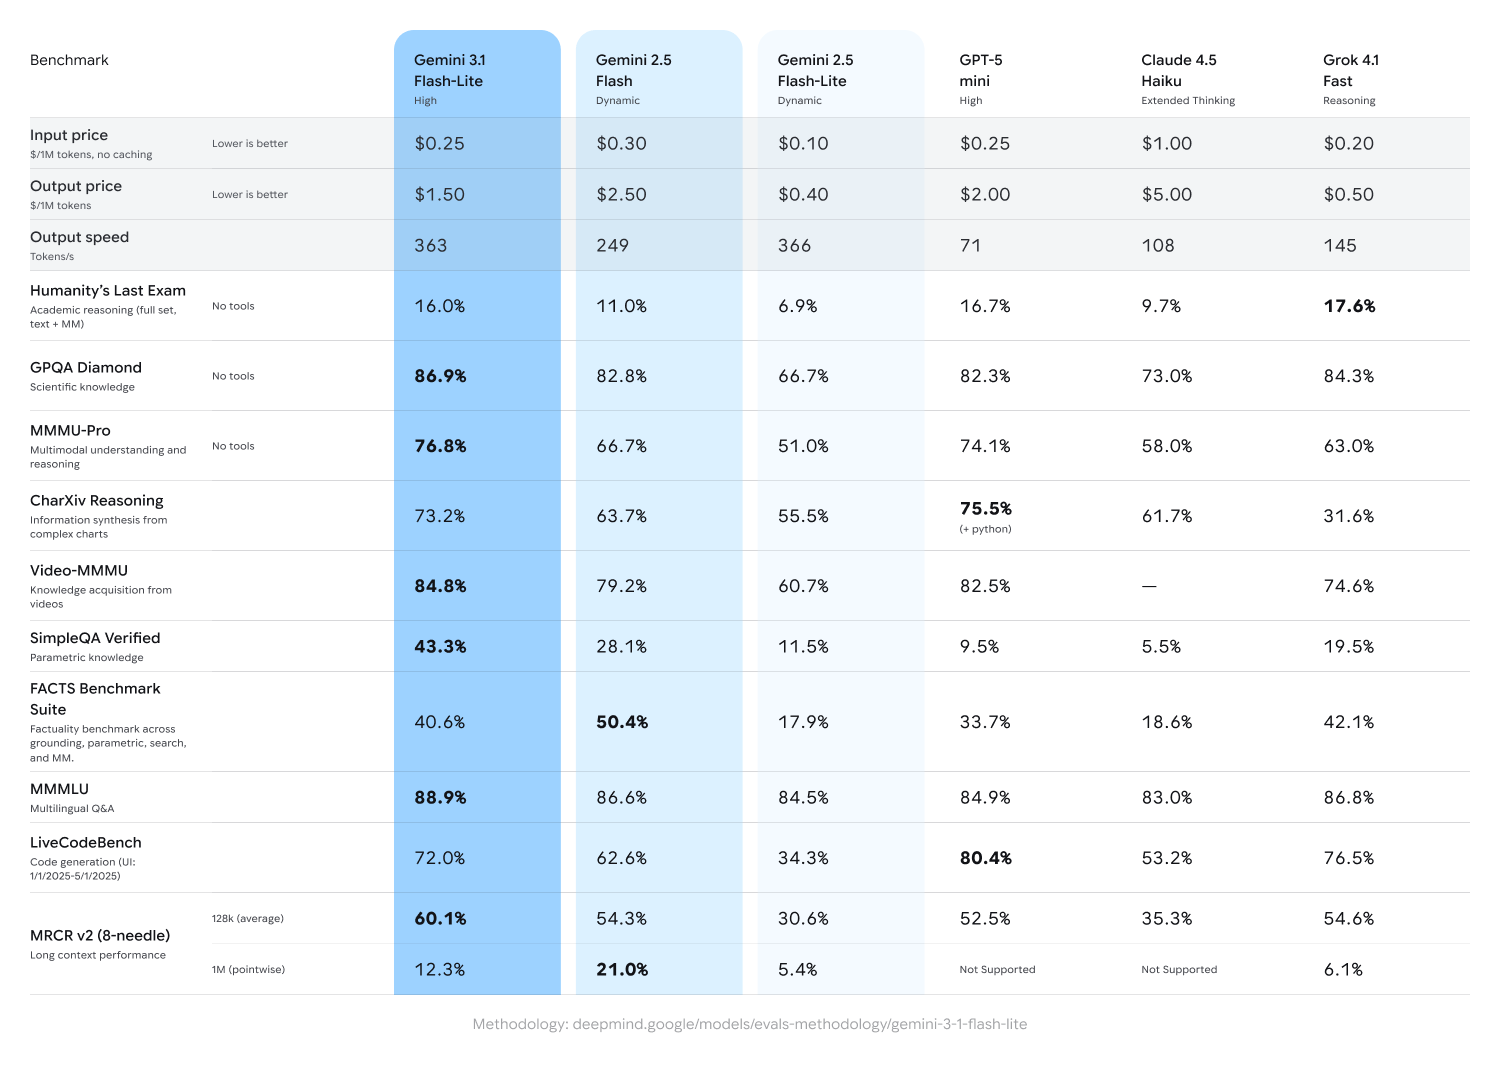
對於需要即時互動的 AI 應用(如客服機器人或即時翻譯)來說,延遲是最大的致命傷。Gemini 3.1 Flash-Lite 在這方面繳出了亮眼的成績單。與前一代的 Gemini 2.5 Flash 相比,它的首字回應時間 (Time to First Answer Token) 大幅縮短了 2.5 倍,整體輸出速度更提升了 45%,達到每秒 363 tokens 的驚人表現。
更值得注意的是,它具備了「動態思考 (Dynamic Thinking)」的特性。這意味著模型不再是死板地用同一套算力處理所有問題,而是能根據任務的複雜程度,自動調配所需的運算資源。簡單的問題秒速給出答案,複雜的邏輯推理則自動投入更多算力思考,大幅提升了整體的運作效率。
破壞性定價,為大規模商業部署而生
除了速度,Token 成本往往是企業導入 AI 時最大的考量。Gemini 3.1 Flash-Lite 開出了極具破壞力的價格:
- 輸入成本: 每百萬 token 僅需 $0.25 美元
- 輸出成本: 每百萬 token 僅需 $1.50 美元
這樣的定價策略,加上極致的反應速度,讓它非常適合應用在需要高頻率、即時回應且大規模擴展的商業場景中。開發者終於可以放心地將 AI 導入即時工作流,而不用隨時擔心 API 費用爆表。
跑分數據展現硬實力:這不是閹割版
雖然名稱裡帶有代表輕量級的「Lite」,但從官方公布的 Benchmark 測試來看,Gemini 3.1 Flash-Lite 的實力不容小覷,在多項關鍵領域甚至直接超越了前代產品 2.5 Flash:
- 社群盲測指標: 在深具公信力的 Chatbot Arena 獲得了 1432 的 Elo 分數。
- 科學知識 (GPQA Diamond): 準確率高達 86.9%(對比 2.5 Flash 為 82.8%)。
- 多模態推理 (MMMU-Pro): 在處理包含圖像、文字的複雜任務時,準確率達 76.8%(對比 2.5 Flash 為 66.7%)。
- 影片知識獲取 (Video-MMMU): 達到 84.8% 的優秀表現。
開發者的新神兵利器
Gemini 3.1 Flash-Lite 的推出,確立了 Google 在輕量級 AI 模型市場的強大競爭力。它證明了「高效能」、「低延遲」與「低成本」三者是可以同時兼顧的。
目前,開發者與企業已經可以透過 Google AI Studio 或是 Vertex AI 平台,使用 Gemini API 搶先體驗這款新模型。如果你正在為你的產品尋找兼具反應速度、推理智力與成本優勢的 AI 引擎,Gemini 3.1 Flash-Lite 絕對值得立刻動手實測。
推薦下一步
Gemini 3.1 Flash-Lite 已經可以在 Google AI Studio 上使用,推薦前往嘗試評估最新的高 CP 值模型。