「JEV」這個名字這幾天在科技圈討論度不低,但對多數人來說,第一個反應大概是:這是另一個聊天機器人嗎?答案是否定的。Jev 是新創公司 TypeSafe AI 在 2026 年 9 月 15 日發表的首款「System One 模型」,它從一開始的設計目標,就跟我們熟悉的 ChatGPT、Claude、Gemini 這類會寫文章、聊天、生成內容的大型語言模型(LLM)不一樣——Jev 完全不輸出自然語言文字,只負責在毫秒等級的時間內,吐出一個「結構化的決策結果」,例如一個分類標籤、一個是非判斷,或是一組帶有信心分數的機率值。
先搞懂一個核心問題:Jev 不是要取代 ChatGPT
TypeSafe AI 的創辦人兼執行長 Diogo Almeida,正是當年協助發展出 RLHF(人類反饋強化學習)與 InstructGPT 技術、進而催生出 ChatGPT 與 GPT-4 的研究者之一,先前任職於 Google Brain。他在推出 Jev 時說:「我們過去一直在優化人類的語言,但這對自動化沒有用,因為電腦講的是另一種語言。」換句話說,Jev 想解決的不是「怎麼讓 AI 更會聊天」,而是「怎麼讓 AI 更適合被軟體直接呼叫、當成系統裡的一個判斷元件來用」。也因為目標完全不同,Jev 從一開始就沒有要跟 ChatGPT、Claude 這類生成式聊天模型正面競爭,而是設計成可以跟它們搭配使用的「決策層」。
System One 模型是什麼?跟一般 LLM 差在哪
「System One」這個命名,靈感來自心理學家丹尼爾.康納曼在《快思慢想》裡提出的「系統一(快速、直覺)」與「系統二(緩慢、深思)」概念。TypeSafe AI 把現有的 ChatGPT、Claude 這類會逐字生成文字、需要深思熟慮的模型歸類為「系統二」式的 AI;而 Jev 這類 System One 模型,則是設計來處理那些不需要長篇推理、但需要極快反應的結構化判斷——像是資料分類、內容審核、風險評分、工作流路由這類「軟體裡常見的 if/else 判斷」,只是把判斷邏輯換成 AI 來做。
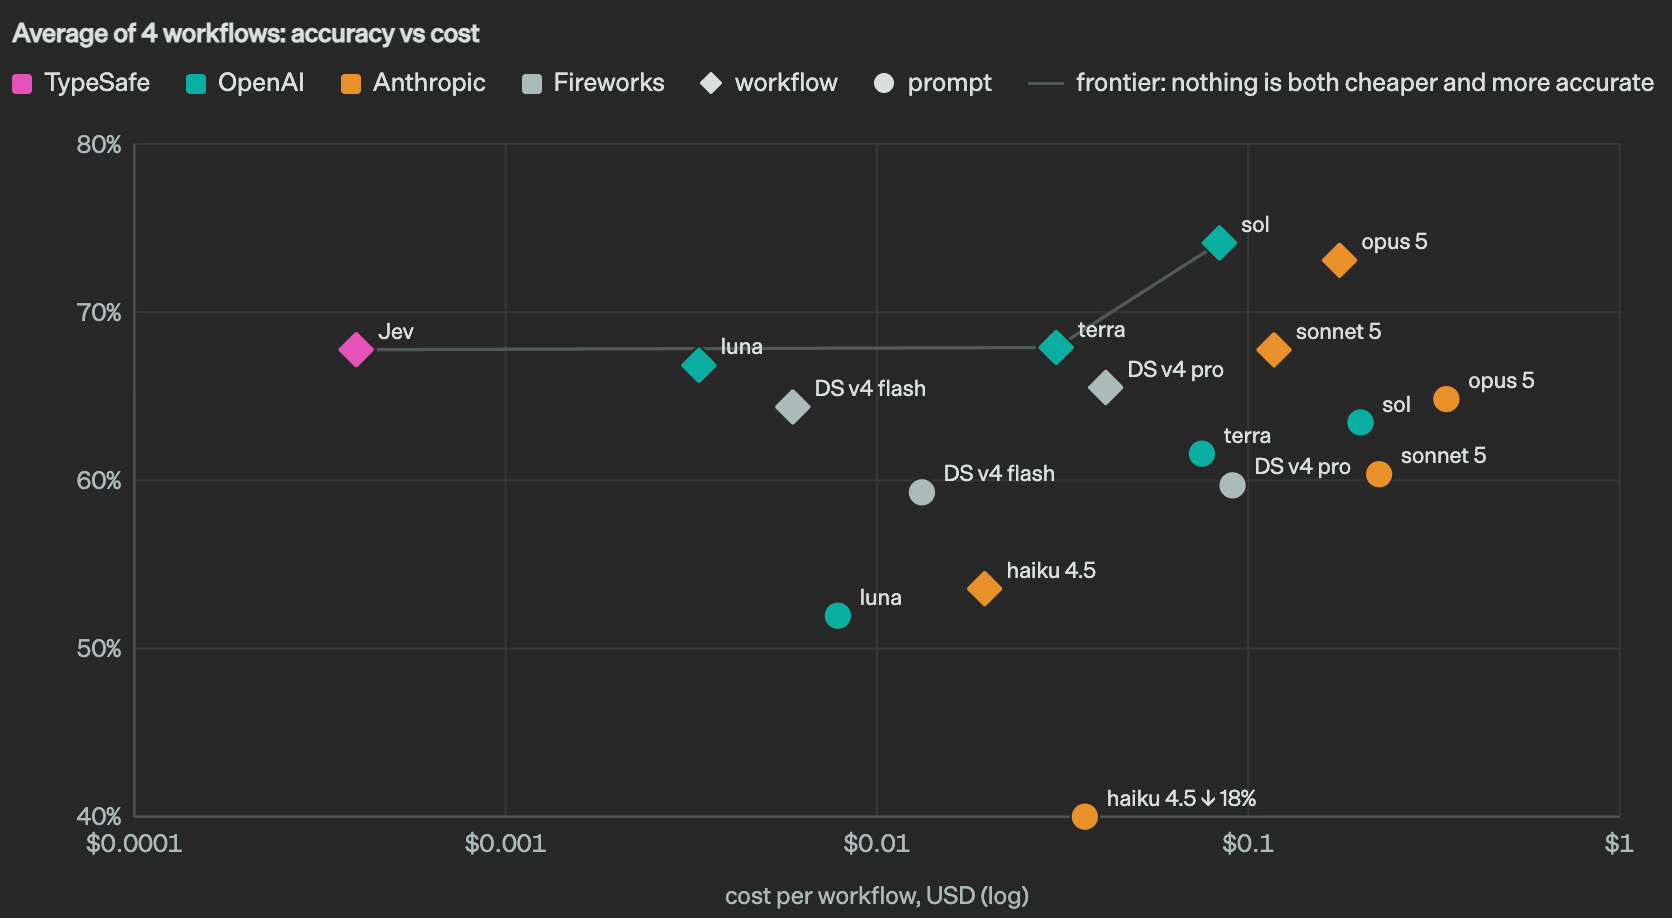
根據 TypeSafe AI 官方部落格公布的內部評測,在這類 System One 任務上,Jev 達到跟現有主流 LLM 相近的準確率,但速度快了 40 到 200 倍以上(部分工作流評測甚至宣稱達到 193.6 倍到 444.6 倍),延遲從一般 LLM 常見的 3 到 329 秒,壓縮到 70 到 500 毫秒之間。收費模式也不同:輸入依然計費,但輸出完全免費——相較於一般 LLM 動輒把輸出定價訂在輸入的 5 倍,這對需要大量呼叫、又只需要簡短判斷結果的應用來說,成本差距非常明顯。
為什麼快這麼多、又不太會「幻覺」?非自回歸推論的原理
一般 LLM 之所以慢,是因為採用「自回歸(autoregressive)」的生成方式——一次只能吐出一個字(token),下一個字要根據前面已經生成的內容繼續往下推算,逐字逐句地把整句話「接龍」出來。Jev 則採用官方所稱的「非自回歸(non-autoregressive)」推論方式,透過新的模型架構搭配平行取樣器,在單一次查詢中把所有輸出同時算出來,不需要逐字接龍,也因此把回應時間壓到毫秒等級。
另一個常被提到的重點是「幻覺」問題。一般 LLM 因為輸出的是自由格式的文字,模型有可能編出看似合理、實際上是錯誤或不存在的答案。Jev 的輸出則被限制在預先定義好的「類型安全」結構值裡(例如固定的分類選項、固定格式的機率分數),官方說法是「在數學上不可能出現類型錯誤」,加上模型訓練方式改用官方稱為 RLCD(校準決策強化學習)的方法、以合成資料訓練,讓輸出的信心分數更貼近實際準確率,而不是像一般 LLM 那樣經常對錯誤答案也表現得很有把握。必須說明的是,「數學上不可能出現類型錯誤」指的是輸出格式一定合法,並不代表 Jev 的判斷內容本身永遠正確——這一點是 TypeSafe AI 官方行銷語言中容易被誤解的地方。
企業實際怎麼用 Jev?
TypeSafe AI 目前公開的案例包括:部署平台 Vercel 用 Jev 取代原本呼叫 OpenAI 模型的安全性審查分類流程,回應速度提升 5 到 18 倍;新創公司 Bryo AI 則用 Jev 處理商業郵件的自動分類,成本降低 10 到 20 倍,同時能取得更真實可用的機率分數,而不只是一個籠統的分類標籤。除了企業實際導入案例,TypeSafe AI 也做了幾個比較「炫技」的展示,包括讓 Jev 以每秒 10 次查詢的速度即時操作,玩《毀滅戰士》(Doom)這款遊戲,藉此凸顯它在即時反應場景下的可用性——不過這類展示更多是用來說明技術可行性,而非代表 Jev 已經被廣泛用在遊戲產業。
綜合來看,Jev 目前鎖定的應用場景相對明確:AI 驅動的工作流程自動化(分類、路由、評分、資訊擷取)、大量資料的即時處理、需要低延遲的使用者體驗場景,以及作為其他 LLM 代理人輸出結果的「守門員」(驗證、評分、抓出異常)。至於需要長篇推理、創意寫作、多輪對話這類任務,仍然是 ChatGPT、Claude 這類「System Two」模型的強項,並不是 Jev 想要處理的範圍。
目前還在邀請制階段
Jev 目前已全面開放註冊,官方也在 evals.typesafe.ai 公開了完整的評測查詢與工作流範例,供有興趣的開發者自行檢視評測方法與數據是否合理。對一般讀者來說,理解 Jev 最簡單的方式,或許就是把它想成「幫軟體裝上一顆會判斷的大腦,但這顆大腦不會跟你聊天」——這也是為什麼它看起來跟大家熟悉的 AI 聊天機器人如此不同的原因。