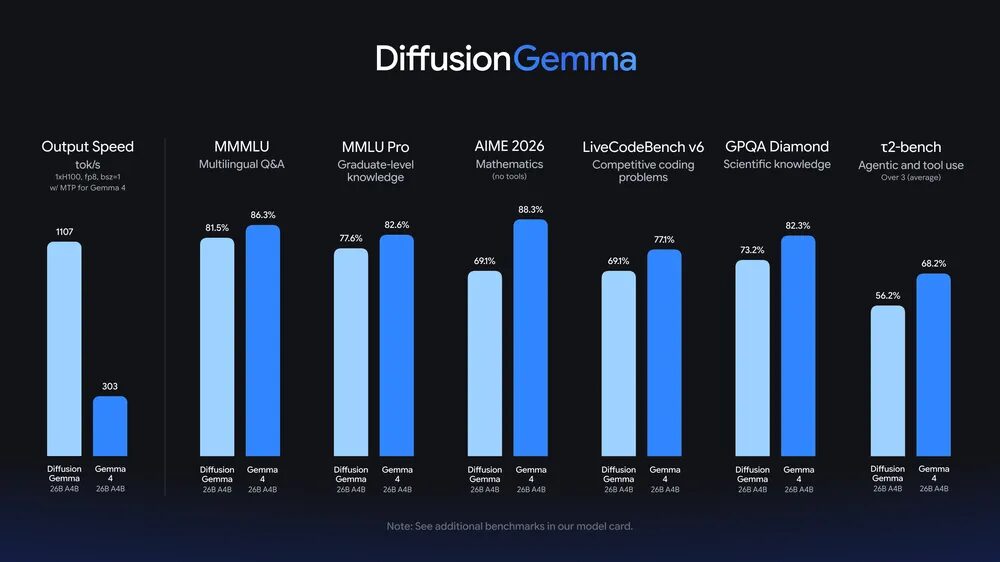
Google 於今日帶來了一項顛覆性的突破,正式推出實驗性開源模型 DiffusionGemma。這款模型捨棄了我們熟悉的逐字生成模式,導入了極速的「文字擴散技術(Text Diffusion)」技術,在特定硬體上實現了高達 4 倍的推論速度提升。
語言模型架構的革新:從「打字機」到「印刷機」
傳統的自迴歸模型(Autoregressive Models)就像一台打字機,必須從左到右、一個 Token 接著一個 Token 順序生成。在雲端伺服器高併發的環境下,這種模式非常高效;但當我們在本地端單點運行時,GPU 大部分的時間其實都在等待下一個「按鍵」的觸發,導致算力嚴重閒置。
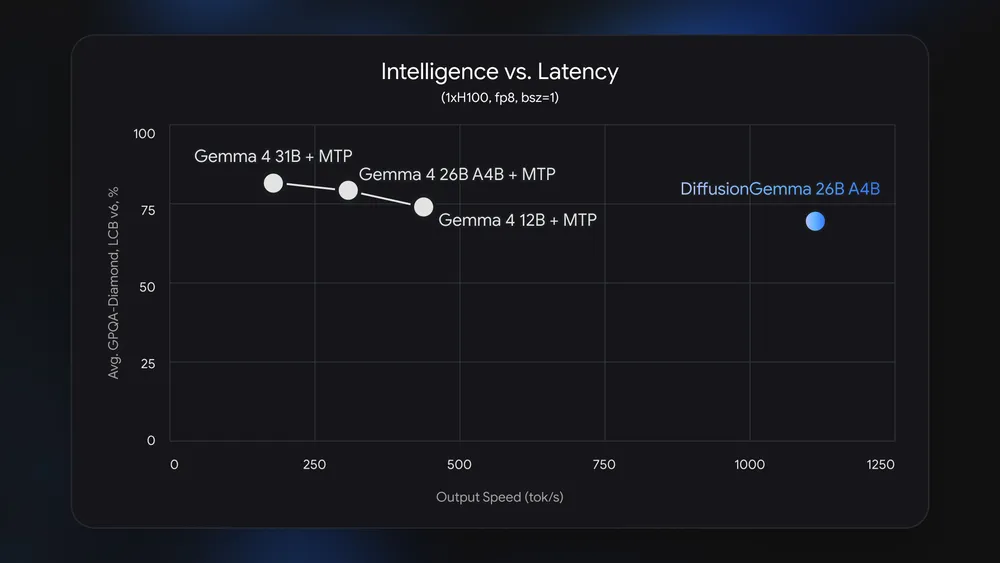
DiffusionGemma 完全反轉了這個低效現象。它採用了類似 AI 圖像生成的「擴散模型」邏輯:
- 建立畫布:先生成一整段包含 256 個隨機佔位符的 Token 區塊。
- 反覆精煉:模型會進行多次掃描,鎖定正確的 Token 並作為上下文線索,即時修正其餘內容。
- 最終打磨:收斂並輸出高品質的完整段落。
這就如同把單調的打字機升級成了「大規模印刷機」,一次印出整段文字,讓你的專屬 GPU 能夠火力全開。
核心亮點:速度與硬體的高效平衡
DiffusionGemma 的基礎建立在 Gemma 4 家族優異的參數性價比之上,其帶來的商業與應用價值主要體現在以下三點:
1. 驚人的生成速度
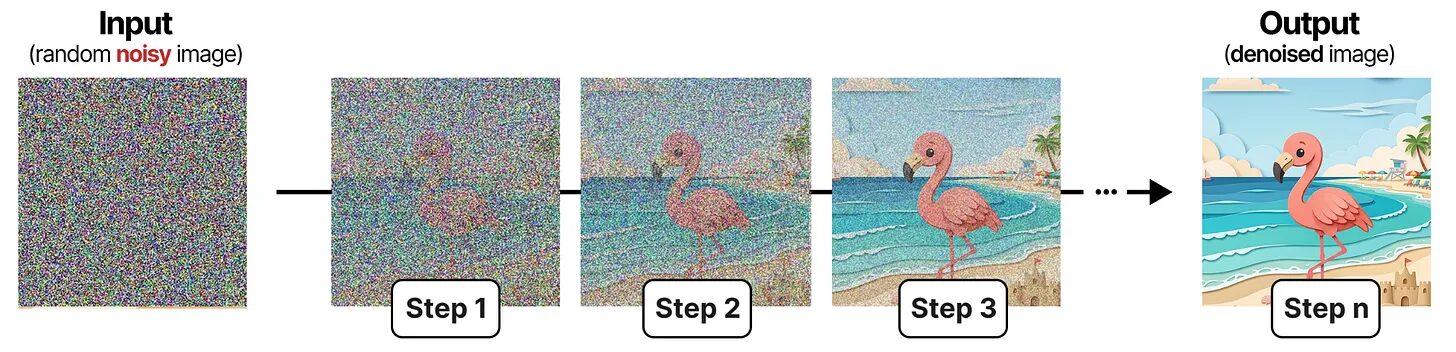
透過將解碼瓶頸從記憶體頻寬轉移到運算核心,DiffusionGemma 在單張 NVIDIA H100 上每秒可生成超過 1000 個 Token;而在消費級的 NVIDIA GeForce RTX 5090 上,也能跑出每秒 700+ Token 的傲人成績。
2. 親民的硬體需求
採用 26B 總參數量的混合專家模型(MoE)架構,在推論期間實際上只會啟動 3.8B 的參數。這意味著在量化(Quantized)處理後,它能輕鬆塞進 18GB VRAM 的消費級高階顯卡中,大幅降低了個人開發者的硬體門檻。
3. 雙向注意力與自我修正
因為一次能處理 256 個 Token,模型在生成時具備「雙向注意力(Bi-directional attention)」。這讓它在處理傳統模型不擅長的非線性任務時如魚得水,例如:程式碼中段填補(In-filling)、胺基酸序列解析、甚至是破解「數獨」。它能在生成過程中統觀全局,即時自我修正錯誤。
與主流模型的取捨:何時該用 DiffusionGemma?
雖然速度極快,但 Google 官方也坦言這是一款針對「速度極致妥協」的實驗性模型。以下是給開發者的應用建議:
- 推薦使用情境:即時互動型應用、行內文字編輯、需要快速迭代的本地化工作流、非線性文本生成。
- 不推薦使用情境:對文字品質要求極高的正式產品輸出(建議改用標準版 Gemma 4)、高 QPS 的雲端大規模伺服器(因並行解碼的邊際效益遞減),以及依賴記憶體頻寬的統一記憶體架構(如 Apple Silicon Macs 的加速體感可能不如獨立顯卡明顯)。
豐富的生態系與開發工具支援
DiffusionGemma 目前採用友善的 Apache 2.0 授權於 Hugging Face 上架。為了幫助開發者快速上手,Google 提供了一系列的支援:
- 模型服務部署:支援 MLX、vLLM 以及 Hugging Face Transformers,官方並預告即將支援 llama.cpp。
- 硬體最佳化:與 NVIDIA 深度合作,支援最新的 NVFP4(4 位元浮點數)加速技術,實現近乎無損精度的極速推論。
- 微調工具:釋出了 Hackable Diffusion 模組化工具箱,同時也相容於 Unsloth 和 NVIDIA NeMo,讓開發者能針對特定任務訓練專屬模型。
未來應用潛力
DiffusionGemma 的出現,象徵著邊緣運算與本地 AI 應用邁入了一個新的里程碑。用速度換取更高的互動性,將讓未來的寫作輔助、即時程式碼生成等工具變得更流暢無感。對於喜歡浸淫硬體與新技術的開發者來說,這絕對是今年必玩的開源模型之一!
相關資源: