近期在 Reddit 的 Codex 討論串中,出現了一個引發眾多開發者共鳴的話題:換上最新的 GPT 5.6 Sol 模型後,原本被視為開發神器的 Superpower Skill,似乎拖慢了整體的工作效率。這個現象並非單一個案,身為長期專注於 AI 工作流程與系統架構設計的開發者,手哥在實際將專案切換至新模型時,也觀察到相同的效能瓶頸。
要釐清這個現象發生的前因後果,我們必須先回到 GPT 5.6 Sol 本身的模型特性與官方的設計邏輯來探討。
為什麼既有的技能框架會成為效能瓶頸?
過去在使用前幾代模型時,為了確保 AI 產出的程式碼符合系統架構規範,我們通常會高度依賴 Superpower 這類結合測試驅動開發 (TDD) 與軟體設計文件 (SDD) 的技能框架,藉由嚴格的步驟拆解與不斷循環的測試,來避免模型在開發中途偏離主題或產生幻覺。
然而,GPT 5.6 Sol 的核心優勢正好在於其卓越的自主規劃能力與長時執行能力。當我們把一項完整的開發工作指派給它時,它已經能夠在背景建立清晰的執行路徑,使命必達的比例相當高。在這種情況下,如果我們依然沿襲舊習,強迫套用 Superpower 繁瑣的開發工作流,系統就必須在模型原有的思考脈絡外,額外執行許多指令要求的冗餘測試與實作步驟。
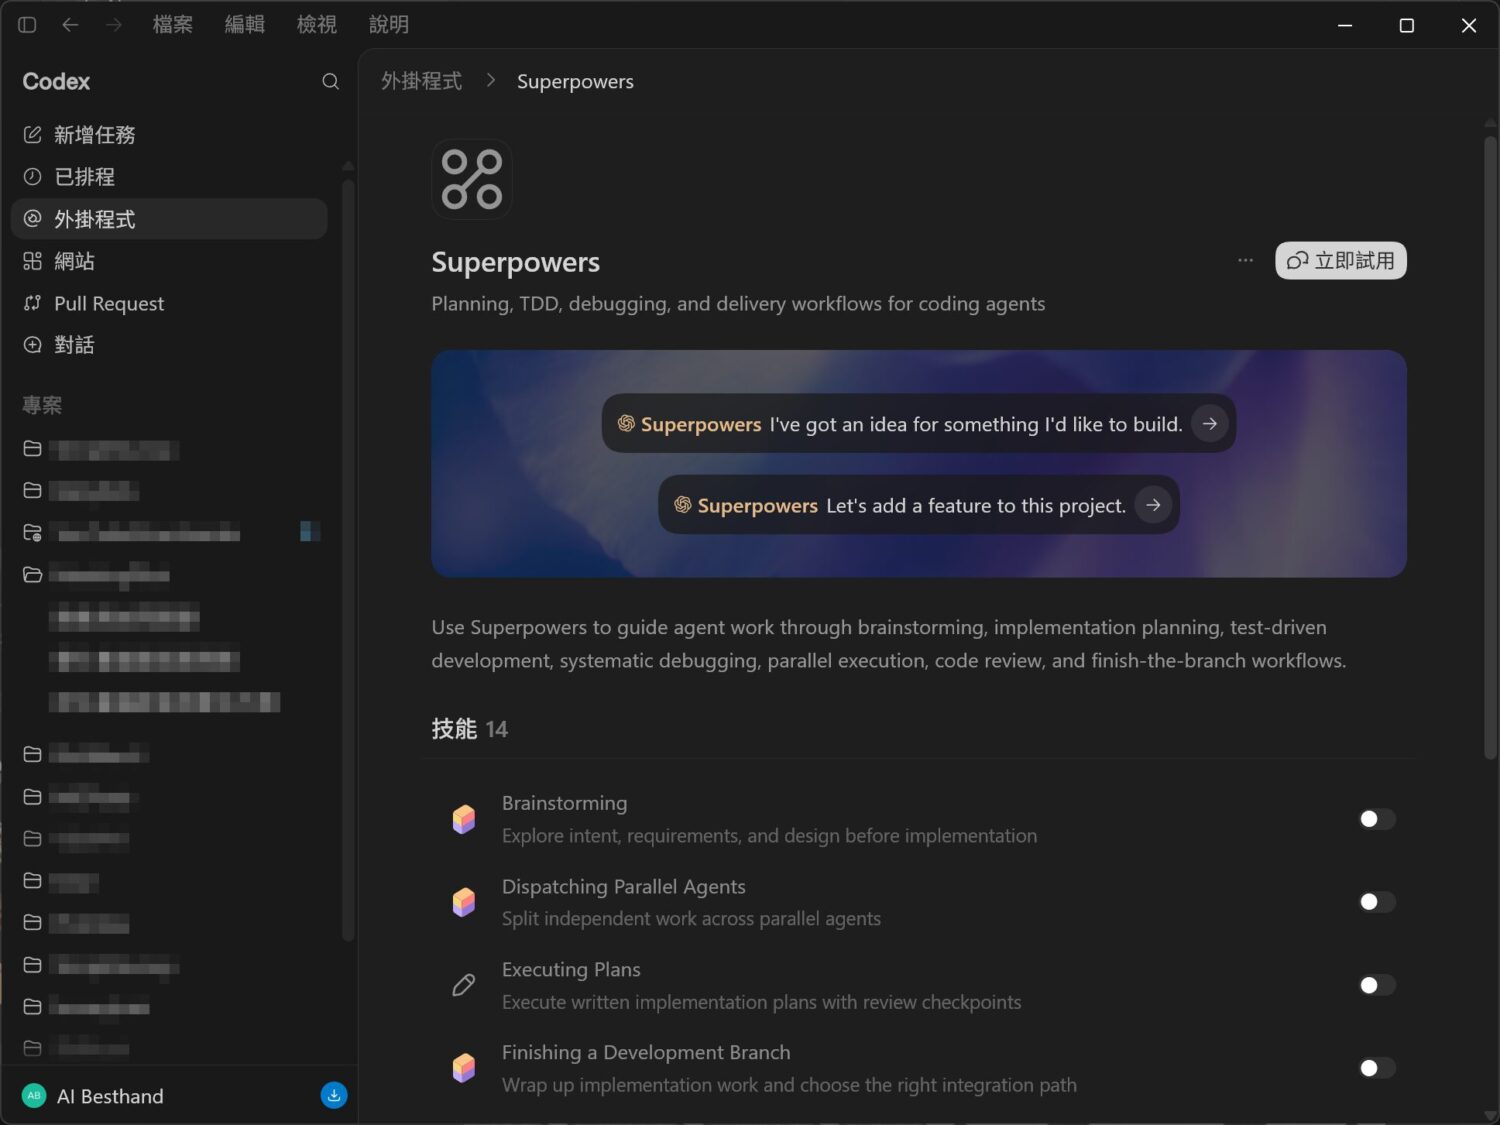
這種過度的外部干預,大幅增加了不必要的 Token 消耗。更嚴重的是,框架的死板限制打斷了模型原生的高效邏輯,導致最終的程式碼品質下降。從 OpenAI 官方發布的 Prompt Guide 中也能觀察到這個趨勢,官方目前的指引更傾向於讓開發者給予明確的高階目標,而非鉅細靡遺的步驟控制。
調整 AI 工作流的務實策略
面對底層模型的進化,我們不需要完全拋棄過去累積的工作習慣,而是應該從系統架構的高度,重新檢視並尋找更適配新模型的工具與設定。
導入 Spectra 維持文件化管理
如果在你的開發流程中,依然高度依賴 SDD 所帶來的優點,例如需要完整的需求文件記錄與清晰的異動清單 (Changelog) 來進行版本控制,那麼改用 Spectra 會是一個相對輕量的選擇。它可以幫助開發團隊維持良好的文件化管理傳統,同時大幅降低對 GPT 5.6 Sol 程式碼生成過程的程序干擾。
捨棄全家餐,改採模組化技能開啟
另一個務實的做法,是改變將所有開發規範「全盤套用」的習慣。在面對不同的開發任務時,我們應該評估當下需求,選擇性地只開啟特定幾項關鍵功能。透過收斂外部指令,給予模型更多的自主發揮空間,我們不僅能省下可觀的 API 成本,也能真正發揮出 GPT 5.6 Sol 在長時任務執行上的潛力。
總結
工具的演進速度極快,在 AI 開發的領域裡沒有永遠適用的單一解法。這次 GPT 5.6 Sol 與 Superpower 之間的適配問題,提醒了我們必須深刻理解每一代新模型的特性。隨時調整我們的溝通方式與工作流設定,才是確保系統架構穩健與開發效率最佳化的關鍵。