問題 2 / 5
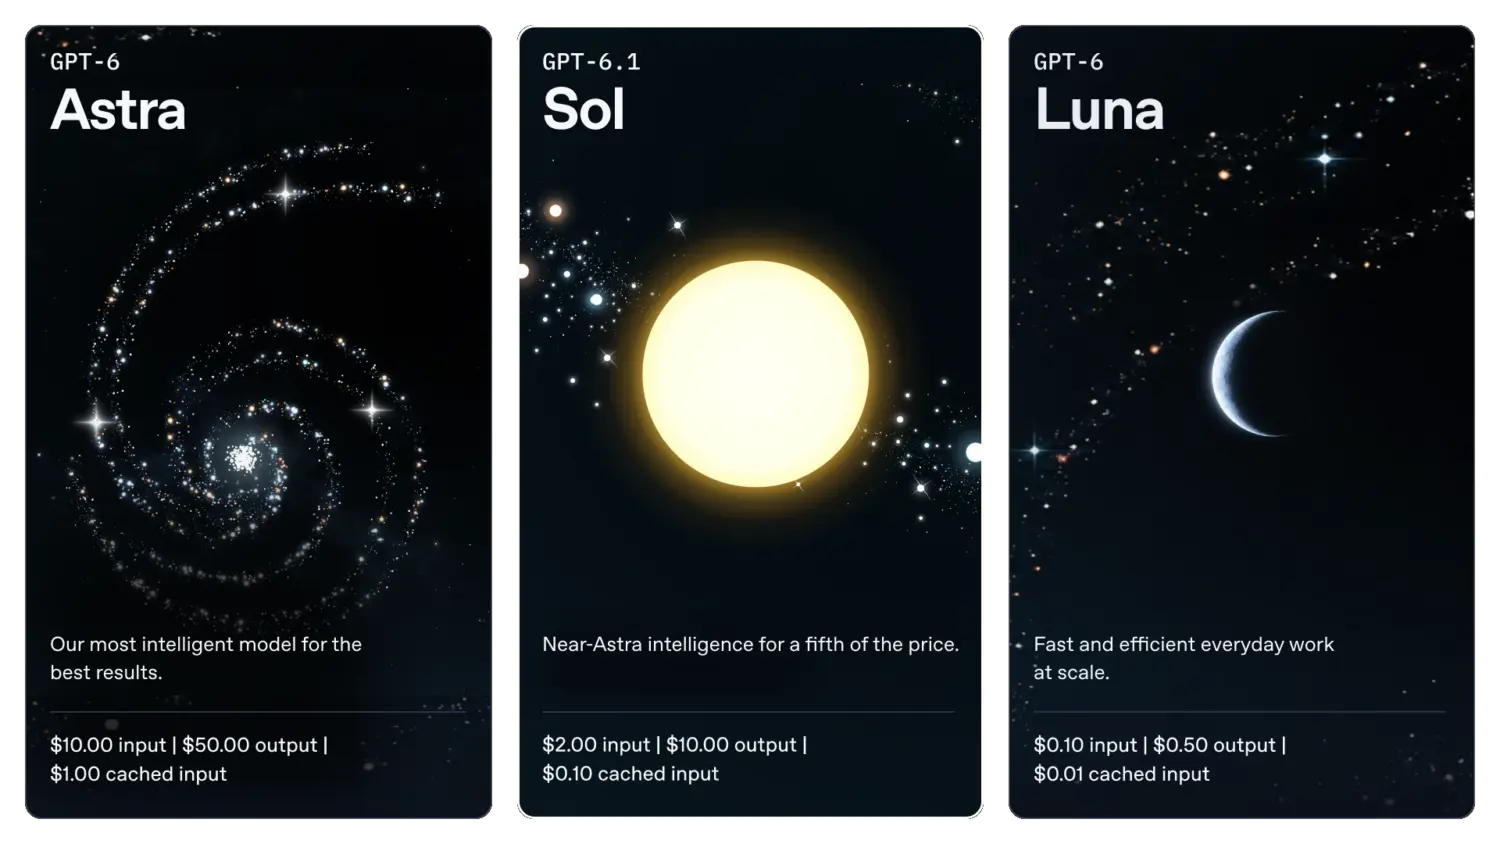
聽說快取輸入 Token 的價格便宜高達 95%,在實際調用 API 時,有什麼具體技巧可以最大化利用這個省錢神技?
AI 根據文章內容回答
想要極致發揮 Prompt Caching 的省錢優勢,關鍵在於「固定結構,前置靜態內容」。以下是三個極具實用性的優化撇步:
- 將 static context(靜態 context)統一放最前面:把長篇的大型提示詞、系統規範(System Prompt)、API 文件或公司產品手冊放在 Prompt 的起頭。只要這段固定內容長度符合門檻且維持不變,後續發送請求時就能穩穩吃到 5 折甚至更高額度的快取折扣。
- 避免動態資訊打亂快取結構:將每次都會變動的用戶輸入、時間戳記或臨時對話紀錄放在 Prompt 的最後方,確保前半段的快取記憶不被破壞。
- 採批次處理(Batch Protocol):如果有大量文件需要處理,儘量集中在短時間內連續呼叫 API,能大幅提升快取命中的機率,避免快取的記憶體因為逾時而被釋放。