問題 1 / 5
想把這套新模型用在目前的日常工作流程中,到底該如何評估什麼時候該選高 CP 值的 Sol,什麼時候又非得請出旗艦級的 Astra?
AI 根據文章內容回答
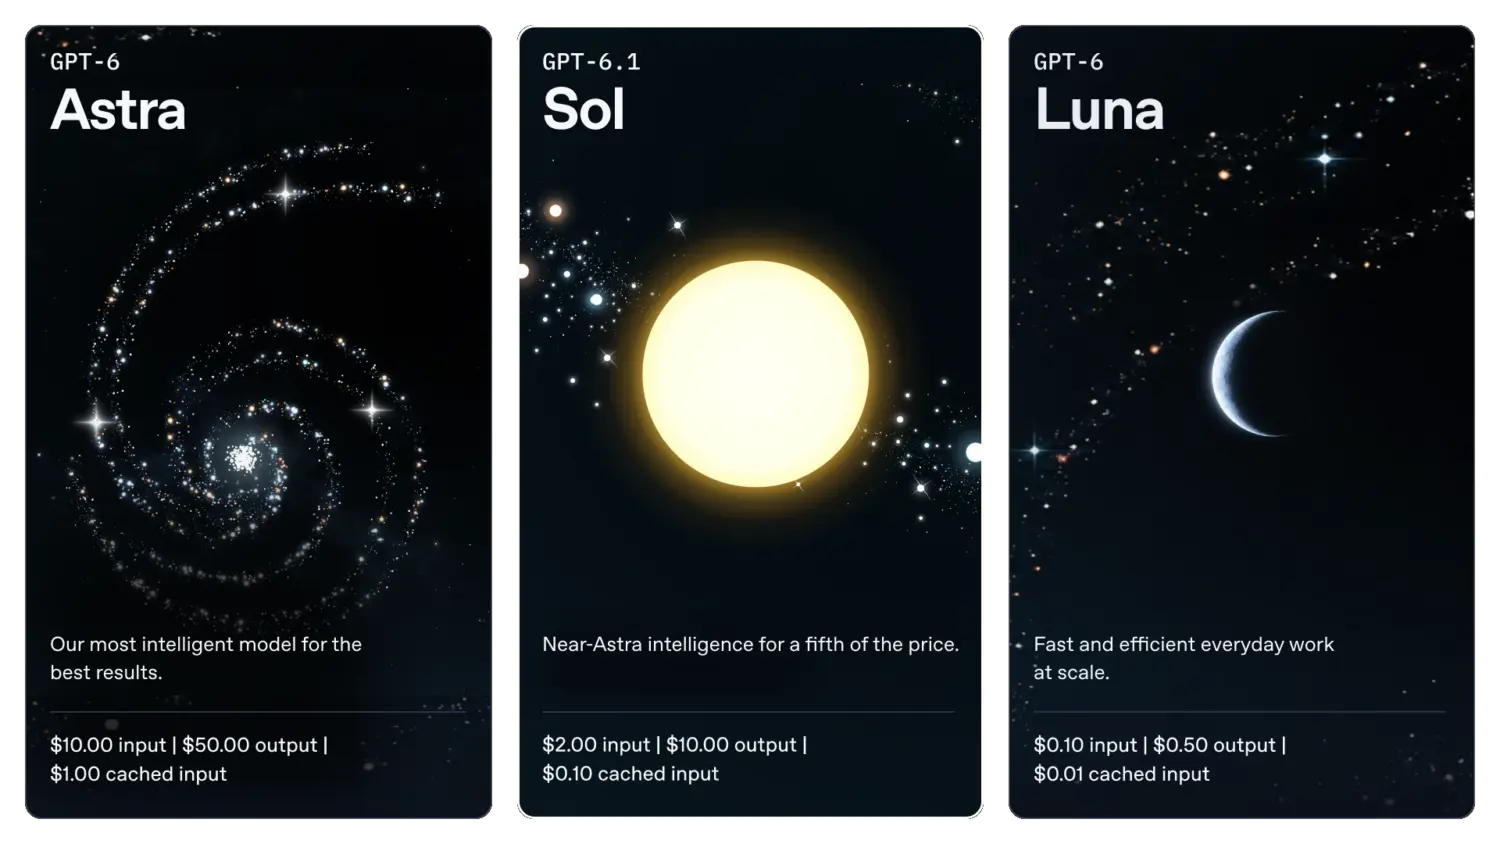
評估模型選擇的核心原則在於「錯誤容忍度」與「任務複雜度」。建議可以依照以下情境建立分工機制:
- 日常開發與常規流程(首選 GPT-6.1 Sol):適合處理大部分的程式碼撰寫、Bug 除錯、結構化表格擷取與常規文件摘要。因為成本極低且效能接近旗艦款,適合需要頻繁測試與迭代的日常工作。
- 關鍵決策與極高精度任務(保留給 GPT-6 Astra):適用於前沿科學研究、涉及法律風險的合約審查或金融交易分析。這類任務絕不能出錯,需要 Astra 最頂尖的邏輯推演與細節把關。
- 高頻率、輕量級互動(選擇 GPT-6 Luna):適合即時客服分類、簡單文字格式轉換等大量且單一的請求。