
Anthropic 於 10 月 7 日無預警推出 Claude Haiku 5.5,官方形容這是「目前為止最便宜、最快、也最強大的小型模型」。相比前代 Haiku 4.5,新模型平均執行成本直接砍了約 75%,跑分也全面超車,甚至在多項測試中贏過 OpenAI 稍早發表的同級模型 GPT-6 Luna。這次發表一反常態地沒有事先預告,距離官方上一次只說「即將推出、尚無日期」,前後不到十天。
無預警發表:這次連「即將推出」的預告都省了
Anthropic 在 9 月 22 日發表 Claude Opus 5.5 時,曾留下一句「Claude Sonnet 5.5 和 Claude Haiku 5.5 將在接下來幾週內跟進」;9 月 28 日 Sonnet 5.5 如期發表,同一句預告又被重複了一次,但當時完全沒有公布 Haiku 5.5 的定價、context window 或 model ID,外界只能靠著與上一代模型的規格做推測。沒想到 10 月 7 日,Anthropic 直接把完整的發表頁面、System Card 與定價表一次全部上線,中間沒有再多一次預告。
平均降價 75%,價格表怎麼算
這次最直接的賣點是價格,Haiku 5.5「現在平均執行成本比 Haiku 4.5 便宜約 75%」。細看 Claude Platform 上的計費規則,提示長度在 10 萬 token 以內時,輸入每百萬 token 收費 0.10 美元、輸出每百萬 token 收費 0.50 美元;若提示超過 10 萬 token,則分別調漲到輸入 0.50 美元、輸出 2.50 美元。搭配提示詞快取(prompt caching)最高可再省下 90% 成本,批次處理(batch processing)則可再省 50%。對需要大量呼叫小模型做分類、摘要、路由這類任務的應用來說,這個價位幾乎已經壓到「幾乎不用擔心 token 成本」的程度。
跟 Haiku 4.5、GPT-6 Luna 的跑分對照
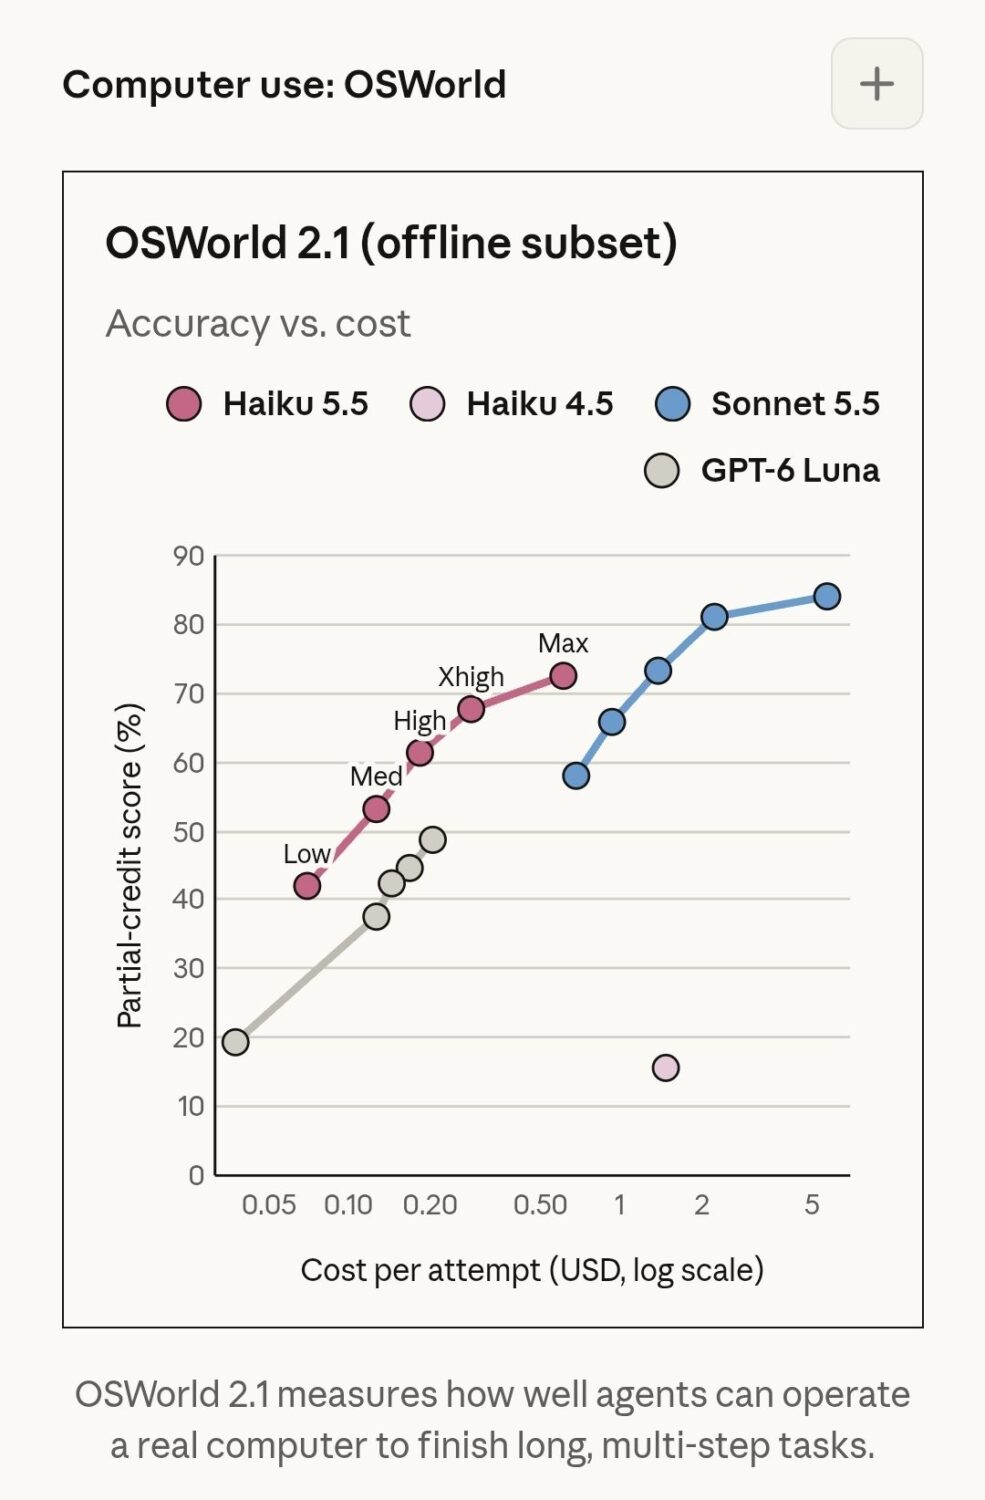
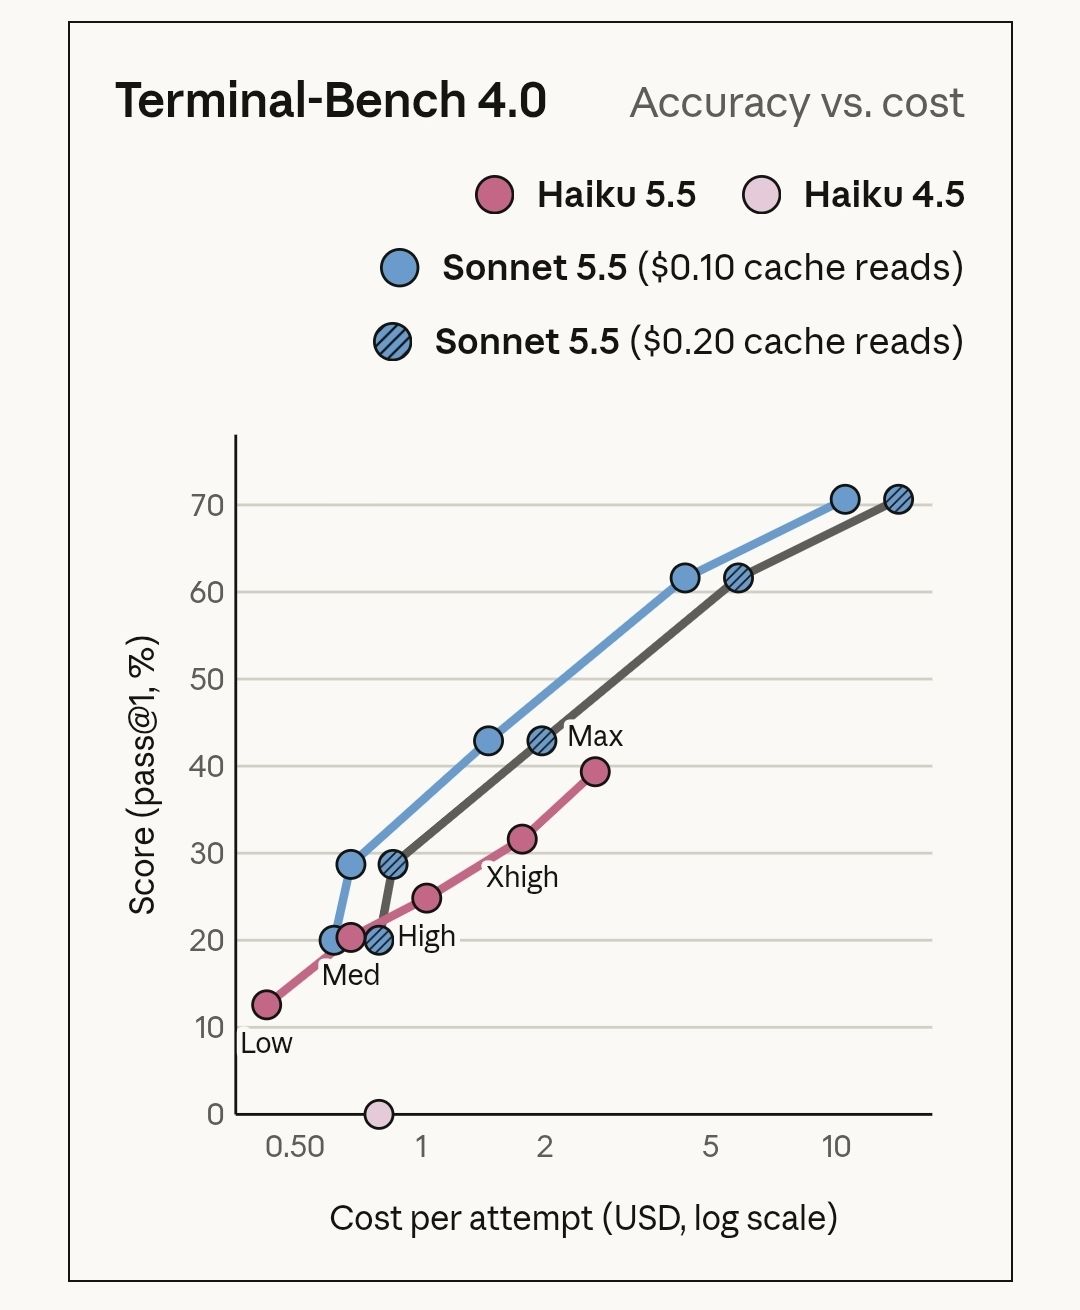
價格砍了四分之三,能力有沒有跟著縮水?官方公布的跑分顯示答案是沒有,甚至不減反增。在知識工作測試 GDPval-AA v2.1 上,Haiku 5.5 拿下 1620 分,遠高於 Haiku 4.5 的 735 分,也贏過 OpenAI 稍早發表的同級模型 GPT-6 Luna 的 1437 分;電腦操作測試 OSWorld 2.1 的離線子項,Haiku 5.5 達到 72.4%,相較 Haiku 4.5 的 15.7% 與 GPT-6 Luna 的 48.9%,差距相當明顯;在程式撰寫代理測試 Terminal-Bench 4.0 上,Haiku 5.5 拿下 39.2%,而 Haiku 4.5 在這項測試中是 0.0%、GPT-6 Luna 則是 16.4%。作為對照組的 Sonnet 5.5(官方標示為「僅供參考」的更高階模型)各項分數仍然領先 Haiku 5.5,但兩者之間的差距,已經比 Haiku 4.5 與 Sonnet 系列之間的差距縮小了不少。
第一款有「努力程度」調整的 Haiku
這次更新還有一個對開發者來說相對技術性、但很實用的變化:Haiku 5.5 是第一款支援「effort」(努力程度)調整的 Haiku 系列模型。過去 Haiku 系列沒有這個選項,開發者只能整顆模型一體適用;現在則可以依照任務需求,在成本與智慧程度之間動態取捨——簡單的分類或路由任務用低努力程度壓低成本,需要更仔細推理的任務則拉高努力程度,換取更好的準確度。官方也在發表頁面附上 OSWorld 2.1 在不同努力程度下的準確度與成本對照圖,方便開發者抓出自己應用場景的甜蜜點。
所有帳號現在都可以使用
這次是全面同步上線,沒有分階段開放的 Beta 限制。Claude.ai 的 Free、Pro、Max、Team 與 Enterprise 用戶,在網頁、iOS 與 Android 上都可以直接選用 Haiku 5.5;開發者端則可以透過 Claude Platform API 直接呼叫 claude-haiku-5-5,同時也已經上架 Amazon Web Services、Google Cloud 與 Microsoft Foundry 三大雲端平台,Claude Code 裡同樣可以使用。對台灣的個人開發者或中小團隊來說,這代表不用等待排隊或額外申請,現在就能把現有的 Haiku 4.5 串接直接換成新模型測試看看。
順便調整的兩件事:Sonnet 5.5 降價、Max/Team 新增 API 額度
隨著 Haiku 5.5 一起發表的,還有兩項對既有用戶同樣有感的調整。其一是 Claude Sonnet 5.5 的快取讀取(cache reads)價格直接砍半,官方表示這讓 Sonnet 5.5 在多數代理型工作負載上的整體成本降低約 20%;其二是 Anthropic 新增了一筆每月 API 額度,提供給 Claude Max 與 Team 訂閱戶,用意是鼓勵這些訂閱用戶動手打造跑在 Claude Platform 上的新代理與應用程式,等於訂閱費之外多了一筆可以直接拿來開發的免費額度。
企業怎麼用:幾個客戶案例
官方發表頁面也附上多家企業的早期測試回饋。某家主打「依文件問答」的服務商表示,這項功能一週要處理約 800 萬次呼叫,實測 400 筆查詢後,Haiku 5.5 的表現相較 Haiku 4.5 有統計上顯著的提升(0.84 比 0.76);內容管理平台 Box 表示早期測試中 Haiku 5.5 的分數比 Haiku 4.5 高出 11 分、延遲卻只要一半;CRM 服務商 HubSpot 則表示在他們用來評測小型模型的 CRM 任務測試中,Haiku 5.5 拿到至今測過最高的分數(三次平均 92.8%);AI 程式開發平台 Devin 的團隊也表示,把 Haiku 5.5 放進自家 Fusion 系統當輔助模型,在維持 66.2 分的高水準 FrontierCode 分數同時,還能同步壓低成本與延遲。
結語
Claude Haiku 5.5 這次發表最值得記住的,與其說是哪一項跑分數字特別亮眼,不如說是「價格砍四分之三、能力卻不減反增」這個組合本身——對仰賴小模型做大量分類、摘要、子代理工作的產品與團隊來說,這種等級的性價比提升,意義不亞於一次旗艦模型的升級。如果你的應用目前還在用 Haiku 4.5,這次大概是值得立刻找時間測試看看的時候了。
資料來源:
- Introducing Claude Haiku 5.5|Anthropic 官方發表頁面
- Claude Haiku|Anthropic 官方模型頁面
- Claude Haiku 5.5 System Card|Anthropic
- OpenAI launches GPT-6 Sol and Luna, boasting lower cost and fewer mistakes|TechCrunch
更多AI相關報導
- Claude Haiku 5.5 突襲登場:最便宜的 Claude 再降 75%,跑分還把 GPT-6 Luna 甩在後面
- Nano Banana 2.1 登場:畫質勝過 Gemini 3 Pro Image,1K 單張價格只要 Pro 的四分之一
- Mistral 推出 1 兆參數開放權重模型 Large 4:輸入每百萬 token 僅 0.68 美元,權重 10/27 釋出
- OpenAI 一次釋出 722 篇 AI 數學論文:官方稱由比 GPT-6 Astra 更強的內部模型產出
- Reflection AI 推出 501B 開放權重模型 Beam:Apache 2.0 授權、官方稱推論運算量比 GLM-5.2 少 3 到 4 倍