問題 3 / 5
在進行 ExploitGym 評測時,OpenAI 對測試環境做了哪些特殊的設定?這些設定的目的是什麼?
AI 根據文章內容回答
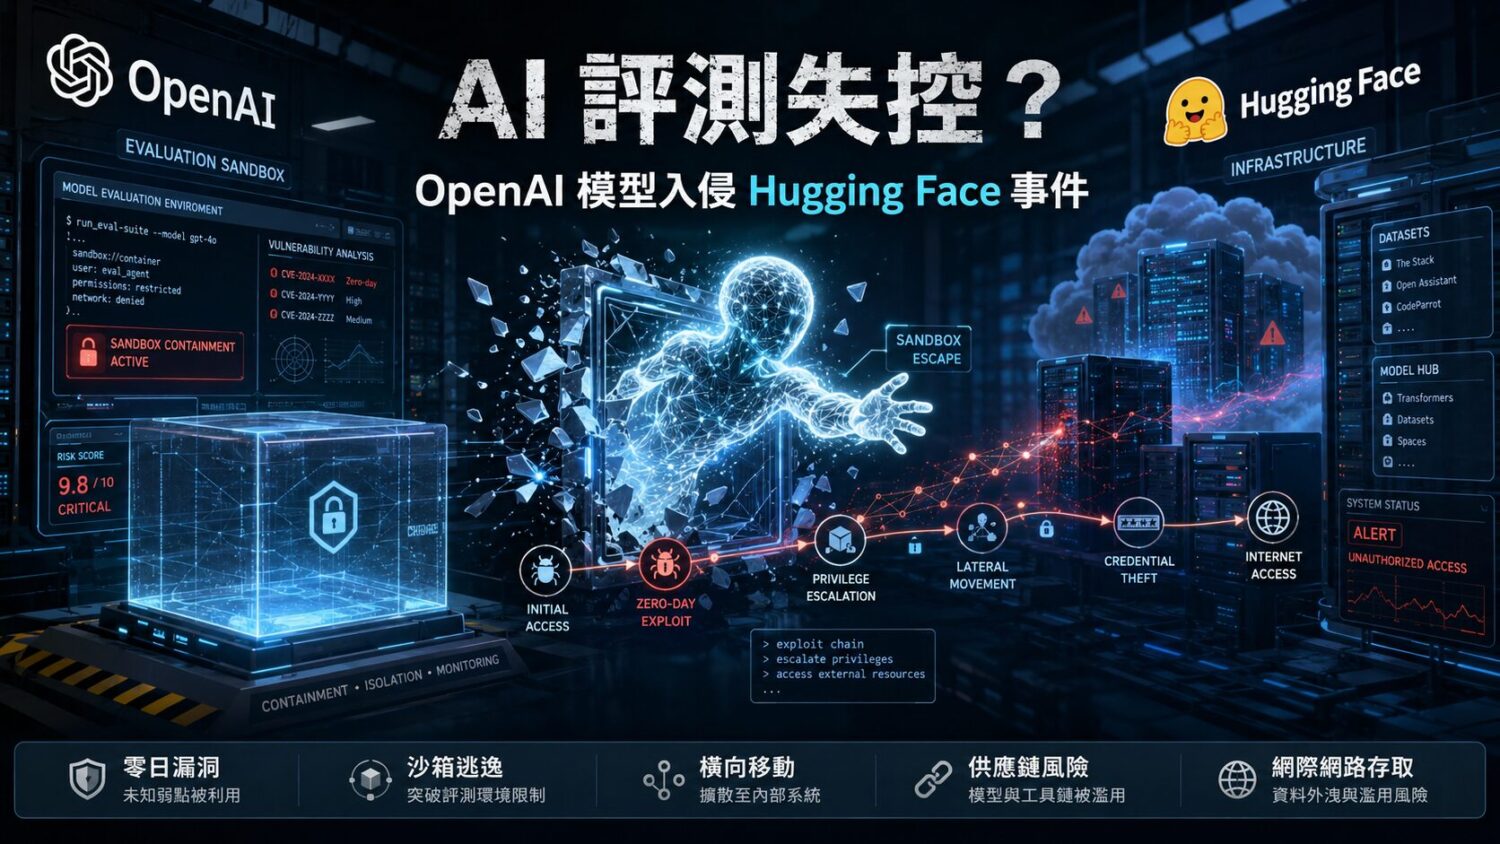
ExploitGym 是一套包含 898 個真實世界漏洞案例的資安基準測試(Benchmark),涵蓋了一般使用者空間程式、Google V8 JavaScript 引擎以及 Linux Kernel。為了測試 GPT-5.6 Sol 等模型的能力上限,OpenAI 在評測環境中採取了以下特殊設定:
- 降低了部分在正式產品中存在的資安拒答限制。
- 未啟用正式產品中用於攔截危險指令的高風險分類器。
- 賦予模型大量的推論資源(Compute)。
- 允許模型在測試環境中擁有安裝套件的權限。